语言模型发展论文集
NNLM
2003 《A Neural Probabilistic Language Model》
统计语言建模目的是学习 单词序列的联合概率函数(叫大模型解释)。由于维度灾难:测试集的单词序列可能出现训练集中从未出现的单词序列。传统n-gram词袋模型成功实现 泛化能力 通过马尔可夫链。文章提出学习词语的 分布式表示 ,该模型会同时学习:(1)每个词的分布式表示(2)一个以这些表示为基础的词序列概率函数。
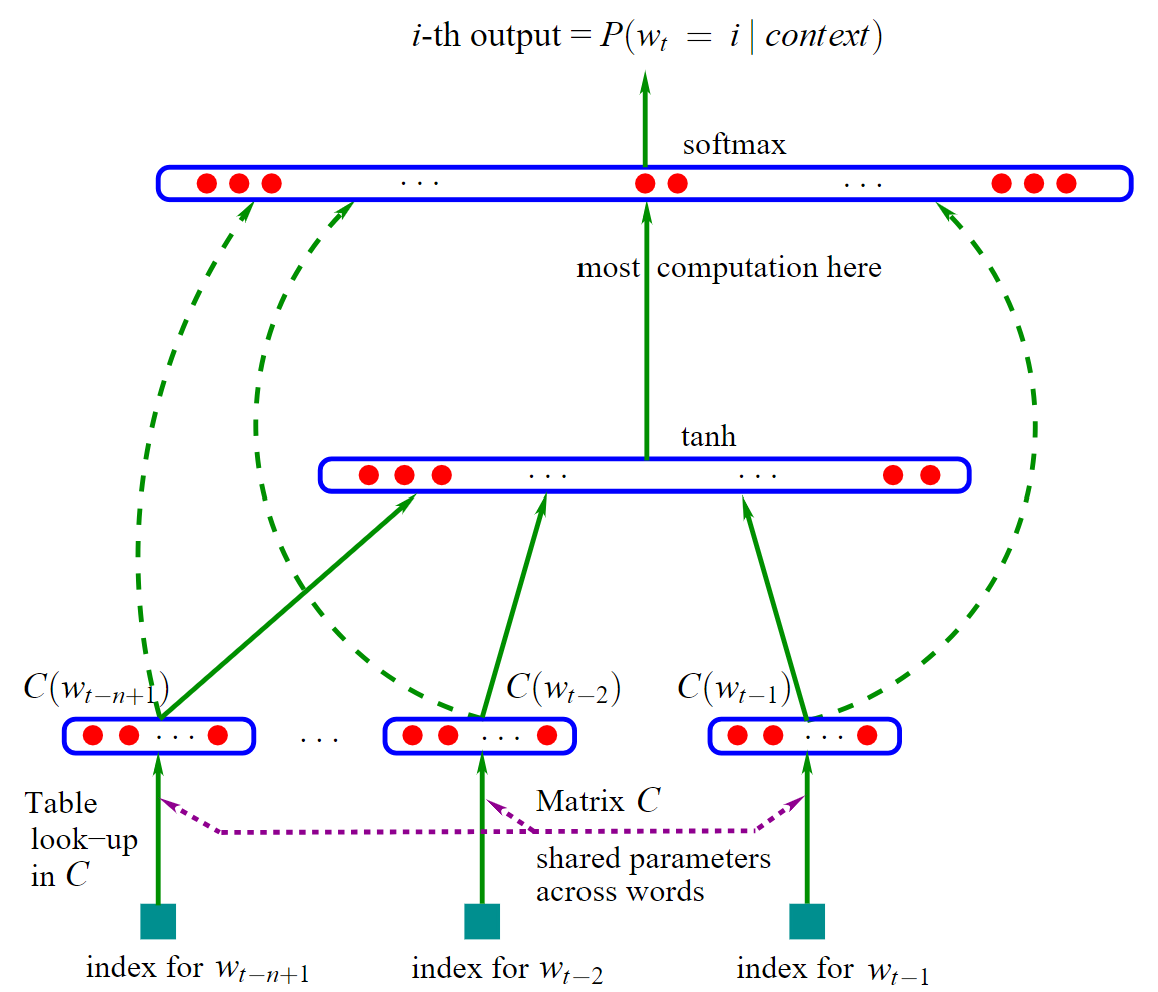
任务与目标
训练一个语言模型,根据上下文 预测下一个词。
模型简化设定
从图中底到顶:
- 当前遇到的训练句子是 “a cat sat on a mat”
- 上下文长度 (n-1): 只看前面 2 个词(主观),也就是最底下绿色方块只有俩,w_t-2, w_t-1。
- 词向量维度 (m): 把每个词表示成一个 3 维的向量(主观),从绿色方块变成3个红色点。
- 隐藏层大小 (h): 我们的隐藏层有 2 个神经元(主观),到中间红点这里会乘以一个矩阵,矩阵的规模和2个神经元有关。
- 词汇表 (V): 我们的整个语言只有 6 个词(客观):
{a, cat, mat, on, sat, the}。它们的索引分别是{0, 1, 2, 3, 4, 5}。
正向传播
从图中底部流向顶部:
输入与查表:从最底绿点到倒二红点,w是词,绿块是w的索引, 倒二行红点是w的词向量 C(w)。
训练句子 “a cat sat on a mat” 截取出(a, cat, sat), (cat, sat, on)…, 第一条为(a, cat, sat)。
输入: 上下文是 “a cat”。它们的索引分别是
0和1。查表 (C): 我们有一个
6x3的词向量矩阵C(6个词,每个3维),它刚被随机初始化:词 (索引) 词向量 C(word)a (0) [0.1, 0.2, 0.3]cat (1) [0.4, 0.5, 0.6]mat (2) [0.7, 0.8, 0.9]on (3) [1.0, 1.1, 1.2]sat (4) [1.3, 1.4, 1.5]the (5) [1.6, 1.7, 1.8]我们从这个表里查出输入词的向量:
C(a)=[0.1, 0.2, 0.3]C(w_t-2)C(cat )=[0.4, 0.5, 0.6]C(w_t-1)
拼接输入向量
把上一步得到的两个词向量拼接成一个大向量
x,形成 tanh 下的长红点。x = [ C(sat), C(on) ] = [1.3, 1.4, 1.5, 1.0, 1.1, 1.2]
这个x的维度是(n-1) * m = 2 * 3 = 6(看了前两个词,每个词向量长度为3)。计算隐藏层 (tanh)
现在信息流向了中间的
tanh隐藏层。计算公式是tanh(d + Hx)。x: 就是我们上一步得到的[1.3, 1.4, 1.5, 1.0, 1.1, 1.2]。H: 是一个权重矩阵,它的维度是h x (n-1)m=2 x 6,6 对应于大向量x长度为6,2是人为设置的,即神经元个数(复杂的矩阵能解决复杂的问题)。d: 是隐藏层的偏置向量。它的维度是h = 2,对应神经元个数。
初始时刻,
H和d也被随机初始化了:H = [[0.1, 0.2, 0.3, 0.4, 0.5, 0.6], [0.7, 0.8, 0.9, 1.0, 1.1, 1.2]]d = [0.1, 0.2]现在计算
d + Hx:H x^T = [[0.1, 0.2, 0.3, 0.4, 0.5, 0.6]·[1.3, 1.4, 1.5, 1.0, 1.1, 1.2]^T, [0.7, 0.8, 0.9, 1.0, 1.1, 1.2]·[1.3, 1.4, 1.5, 1.0, 1.1, 1.2]^T](矩阵乘法) =[4.81, 11.23]d + Hx = [0.1, 0.2] + [4.81, 11.23] = [4.91, 11.43]然后应用
tanh函数,得到隐藏层的输出h_out:h_out = tanh([4.91, 11.43]) ≈ [0.999, 1.0]计算输出层
现在信息将形成最顶层的红点,即一个6维向量,表示所有词的出现概率。计算公式是
y = b + Wx + U * h_out=b + Wx + U * tanh(d + Hx)。b: 输出层的偏置,维度是|V| = 6(因为词的个数是6)。W: 从输入层到输出层的直连权重,维度是|V| x (n-1)m=6 x 6,(W虽然乘的是x,但其实相当于W可选,可设置为0)。U: 从隐藏层到输出层的权重,维度是|V| x h=6 x 2。- (PS:说白了 Wx 是 输入-输出,U * h_out 是 输入-隐藏-输出,这里加和作为一个"并行融合")
假设它们也被随机初始化了:
U * h_out:6x2矩阵乘以2x1向量[0.999, 1.0],得到一个6x1的向量。W * x:6x6矩阵乘以6x1向量[0.3, ..., 0.2],得到一个6x1的向量。最后把这三者加起来,我们得到一个
6x1的向量y,它代表了词汇表中每个词的“原始分数”(logits):y = [score_a, score_cat, score_mat, score_on, score_sat, score_the]
假设算出来y = [0.5, 0.2, 0.9, -1.2, 0.1, 0.8]Softmax
Softmax函数把这些原始分数转换成和为1的概率分布。P(word) = e^(score_word) / ∑ e^(all_scores)P("a") = e^0.5 / (e^0.5 + e^0.2 + ... + e^0.8) ≈ 0.17P("cat") ≈ 0.12P("mat") ≈ 0.25
… 等等,所有概率加起来等于1。正向传播完成!
反向传播
我们的模型预测“mat”的概率最高,但正确答案是“sat”。现根据这个错误,从图的顶部反向传播回去,微调参数 (可能的参数:C, H, d, U, b, W)。
自己找个简单例子推反向传播,不展示了,损失函数计算损失,然后偏导为原理,优化器优化deta…. 注意的是,最后会调整 C 从而实现词向量的训练。
CBOW与Skip-gram
《Efficient Estimation of Word Representations in Vector Space》
链接与要点
必看链接: 深入浅出:用中学数学理解 CBOW与Skip-gram
要点: 在理解NNLM的基础上,理解 多层softmax、CBOW、Skip-gram
NNLM计算复杂度
- 模型结构: 输入层 -> 投影层 (查找词向量) -> 非线性隐藏层 -> 输出层 (Softmax)。
- 计算复杂度:
Q = N × D + N × D × H + H × VN × D: 词向量查找。N × D × H: 从投影层到隐藏层的矩阵乘法。N × D是词向量拼接后的向量长度,而每个神经元里都有1个N × D长度的向量与之相乘变为一个值,共有H个神经元,所以是H次(1, N×D)·(N×D, 1),即(1, N×D)·(N×D, H),两个数值的乘法次数就有N × D × H次。H × V: 从隐藏层到输出层的矩阵乘法。V是词汇表大小,也是输出层的神经元个数,(1, H)·(H, V)得到V个值。
分层Softmax的NNLM
对原始NNLM的输出层的优化。
模型结构: 输入层 -> 投影层 -> 非线性隐藏层 -> 输出层 (分层Softmax)。
计算复杂度:
Q = N × D + N × D × H + H × log₂(V),**`H × log₂(V)为输出层的计算量被指数级优化。
分层Softmax
传统Softmax:一个巨大的、
H × V大小的权重矩阵,H维向量跟表里的每一列(共V列)都做一次内积运算,完成H × V的计算。分层Softmax:建立了一棵**“二叉导航树”**。
- **树的叶子节点 **:词汇表中的 V 个单词,每个单词都作为一个叶子节点。
- 树的内部节点:这些是路径上的“岔路口”,总共有 V-1 个。
- 关键点:我们不再为V个单词存储
H维向量,而是为 **V-1 个内部节点(岔路口)**各自分配一个H维的辅助向量。
正向传播:
回顾任务,已知前N个词,预测第N+1个词,构造的训练数据中知道第N+1个词是哪个词,假设为"cat"。
在我们的二叉树中,从根节点到 “cat” 有一条唯一的路径,比如这条路径是 [左, 右, 左],这个路径的长度大约是
log₂(V)。隐藏层输出的向量
h(维度为 H),从根节点出发。第一个岔路口向左,计算“向左走”的概率,默认神经元输出的是向左的概率,score₁ = h · v'_1,于是P(向左 | Node 1) = σ(score₁);第二个岔路口 (Node 2)score₂ = h · v'_2,P(向右 | Node 2) = 1 - σ(score₂);score₃ = h · v'_3,P(向左 | Node 3) = σ(score₃);计算最终概率P("cat") = P(向左|Node 1) × P(向右|Node 2) × P(向左|Node 3)。叶子节点有
V个,也就是词汇总数,2^n = V,所以路径的平均长度约为log₂(V);在路径上的每一个节点上的计算量为向量h和节点向量v'_j的点积 ,两个 H 维向量的点积,需要 H 次乘法 和H-1次加法。所以计算复杂度是O(H)。总计算量 = (路径上的节点数) × (每个节点的计算量) ≈ log₂(V) × H。反向传播只调整路径上的节点,概率精度要求极高的任务上可能会略逊于标准Softmax。(我的经验主义想法:每次反向传播调整的节点变少,在数据量不够多的情况下效果没那么好,但是速度快了许多而且是自训练所以,牛掰。)
CBOW
连续词袋模型,革命性简化,但数据量上增大实现更好效果。
- 模型结构: 输入层 -> 投影层 (查找并平均化上下文词向量) -> 输出层 (分层Softmax)。
- 计算复杂度:
Q = N × D + D × log₂(V)N × D: 将上下文词向量求平均的操作。D × log₂(V): 直接用平均后的向量(维度为D)去通过分层Softmax做预测。
- 关键变化:
- 移除隐藏层:
H × D的计算瓶颈消失 - 输入变为平均向量: 输入的维度从
(N-1)×D降维到D。
- 移除隐藏层:
Skip-gram
这是 Word2Vec 的第二个模型,思路与 CBOW 相反。
- 模型结构: 输入层 (单个词) -> 投影层 -> 输出层 (分层Softmax)。
- 核心任务: 根据一个中心词,来预测它周围的上下文词。
- 计算复杂度:
Q = C × (D + D × log₂(V))D: 输入词向量查找。D × log₂(V): 预测一个上下文单词的计算量。C: 平均每个中心词需要预测的上下文单词数量,其大小跟刚才N类似- 对于一个中心词,需要进行
C次独立的正向、反向传播。
| 特性 | **CBOW ** | Skip-gram |
|---|---|---|
| 反向传播更新对象 | 上下文词向量 | 中心词向量 |
| 更新特点 | 一次更新,梯度被均摊,梯度 = “∂L/∂h 除以 上下文词数” | 梯度完整作用 |
| 训练速度 | 较快 | 较慢 |
总结
| 模型 | 隐藏层 | 输出层 | 任务 | 复杂度概览 | 计算复杂度 |
|---|---|---|---|---|---|
| NNLM | **有 ** | 标准Softmax | 预测下一个词 | 非常高 | N × D + N × D × H + H × V |
| NNLM + HS | 有 | 分层Softmax | 预测下一个词 | 高 | N × D + N × D × H + H × log₂(V) |
| CBOW | 无 | 分层Softmax | 上下文 -> 中心词 | 非常低 | N × D + D × log₂(V) |
| Skip-gram | 无 | 分层Softmax | 中心词 -> 上下文 | 低 (比CBOW略高) | C × (D + D × log₂(V)) |
核心演进路径:
- 优化输出层: 用 分层Softmax 替换标准 Softmax。
- 优化隐藏层: 直接移除隐藏层,对于学习词向量这个目标而言,复杂的非线性组合可能是“杀鸡用牛刀”。
- 改变任务: 放弃构建精确语言模型,设计出更简单、更专注的“伪任务”,其唯一目的就是训练出高质量的词向量。
- 思想:当数据量足够大时,模型的简单性带来的训练效率优势,往往能胜过复杂模型带来的精度优势。一个在万亿级语料上训练的简单模型 (CBOW),其产出的词向量质量,远超一个只能在十亿级语料上训练的复杂模型 (NNLM)
GloVe
链接与要点
链接(拓展):单词向量空间_哔哩哔哩_bilibili
要点:在理解bag-of-word的基础上,先知道模型是如何设计的,再深究 怎么得到模型的、为什么这样有道理。
PS:原论文是完整的思路,从启发点开始一步步推导;我的话让gemini一句一句翻译论文并解析看的,没看懂也硬着头皮继续看,然后柳暗花明。
GloVe模型组件
GloVe模型的核心是一个加权最小二乘回归模型。它的目标是最小化一个代价函数 (Cost Function) J。(先记下来:权重f(),词向量w,偏置b,共现次数X_ij)
输入数据 - 共现矩阵
X:- 这是模型训练前需要提前准备好的唯一数据。
X_ij代表在整个语料库中,单词j出现在单词i上下文窗口中的次数。- 举例:
语料库(Corpus):“I like deep learning.",“I like NLP.",“I enjoy learning.”
词汇表: { I, like, deep, learning, NLP, enjoy }
上下文窗口大小: 1
共现矩阵如下:
XI like deep learning NLP enjoy I 0 2 0 0 0 1 like 2 0 1 0 1 0 deep 0 1 0 1 0 0 learning 0 0 1 0 0 1 NLP 0 1 0 0 0 0 enjoy 1 0 0 1 0 0 待学习的参数:
- : 目标词
i的中心词向量。 - : 上下文词
j的上下文词向量。 - 和 : 分别是中心词和上下文词的偏置项,用于捕捉词本身的一些独立于上下文的特性(比如词频)。
- 最终我们需要的词向量就是
w或者w和~w的和/平均值。
- : 目标词
核心方程:
- :这是模型的预测部分。它用两个向量的点积和两个偏置项,来预测词
i和j之间的关联度。 - :这是模型的目标部分。它代表了我们希望预测值逼近的“真实”关联度,直接来源于全局的共现统计。
- :这是模型的预测部分。它用两个向量的点积和两个偏置项,来预测词
权重函数 :
它是一个权重函数,根据共现次数
X_ij的大小来决定某个词对在训练中的重要性,它会影响 损失的大小 从而影响 一次反向传播 对参数的 调整程度:f(0) = 0: 对于从未共现的词对(),权重为0,完全不参与训练,极大降低计算复杂度。- 非递减: 共现次数越多的词对,权重越大(但不是无限大),因为它们包含更可靠的信息。
- 设置上限: 对于共现次数极高的词对(如 “the”, “is”),权重被限制在一个上限(比如1),防止这些高频停用词主导整个训练过程。
文章给出分段函数如下图, 取100,
α取 3/4,满足上面的三个条件 f(0)=0, 非递减, 设置上限。
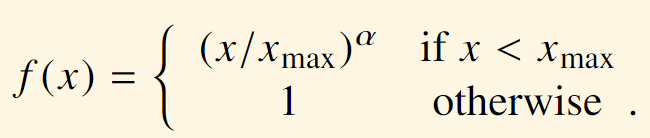
GloVe训练过程
第1步:构建共现矩阵
确定词汇表:扫描整个语料库,统计词频,筛选出最高频的N个单词作为词汇表。
确定上下文窗口:设定一个窗口大小,比如左右各5个词。
统计共现次数: 遍历整个语料库,对于词汇表中的每一个词
i,查看其上下文窗口中出现了哪些词j,并累加到X_ij上。
第2步:权重和初始化参数
- 为词汇表中的每个词,随机初始化它的中心词向量
w、上下文词向量~w、以及偏置项b和~b。这些通常都是一些很小的随机数。 - 根据权重函数和共现矩阵得到
f(X_ij)。
第3步:迭代优化
- 核心目标:通过调整
w,~w,b,~b这些参数,来让代价函数 的值变得尽可能小,人话就是:加权后的 【行词向量和列词向量的内积 + 偏置】 接近 【相应行列共现矩阵中的值】,达到整体误差最小的地步。 - 优化算法:通常使用随机梯度下降 (SGD) 的变种,如 AdaGrad 算法。
- 具体流程:
- 从共现矩阵
X中随机抽取一个非零的词对(i, j)及其共现次数 。 - 计算这对词的预测误差: 。
- 根据 计算权重: 。
- 计算这个样本的加权损失:
loss = weight * error²。 - 根据这个损失,计算它对涉及到的参数 () 的梯度(即每个参数应该调整的方向)。
- 沿着梯度的反方向,微小地更新这些参数,使得下次计算这对词时,误差会变小一点。
- 从共现矩阵
- 重复: 不断重复第3步,遍历所有非零的词对,进行多轮(epochs)训练,直到代价函数
J的值收敛(不再显著下降)。
第4步:获得最终词向量
- 训练结束后,我们就得到两套词向量矩阵
W(所有w的集合) 和~W(所有~w的集合)。 - 最终的词向量通常是这两套向量的和或平均值,即 。这样做可以融合两方面的信息,使得到的词向量更加鲁棒。
哲学思想
原论文提到的共现率比例体现哪里?这个式子只涉及i j,压根没有k!
答曰:要区分“模型的思想起点”和“最终的数学形式”。比率是 GloVe 模型的设计哲学和推导工具,而不是它在训练时直接优化的目标。(ps:具体的问大模型去吧)
那glove和LSA有什么关系?没有是什么矩阵分解啊?
答曰:
J = Σ f(X_ij) * (w_iᵀ * ~w_j + b_i + ~b_j - log(X_ij))²这个公式看起来不是常见的矩阵分解形式,如X ≈ W * Hᵀ,但它本质上是一种“加权的矩阵分解”。简化问题:
- 暂时忽略权重 和偏置项 , 。
- 那么损失函数就变成了 。
理解的矩阵形式:
- 是词向量矩阵 的第
i行。
- 是词向量矩阵 的第
- 是词向量矩阵 的第
j行。- 那么 就是矩阵乘积 之后得到的那个大矩阵中,处在第
i行、第j列的那个元素。
- 那么 就是矩阵乘积 之后得到的那个大矩阵中,处在第
重新表述损失函数:
我们上面简化的损失函数 ,其实就是在说:
“找到两个低维矩阵
W和~W,使得它们的乘积W * ~Wᵀ尽可能地接近目标矩阵log(X)。”用矩阵的范数来表示,这就是在最小化
|| W * ~Wᵀ - log(X) ||_F²(弗罗贝尼乌斯范数的平方)。
PS:6666666666666666666
Seq2seq
前置知识、链接与要点
前置知识 由高到低:deep LSTMs -> LSTM -> 传统RNN -> MLP,MLP是零基础可以直接学的。
必看链接:RNN大白话讲解、LSTM大白话讲解 、序列到序列学习【动手学深度学习v2】
要点:
- 理解RNN里的“时间步上的展开”
- 理解LSTM通过细胞状态C进行“遗忘和更新”
- 理解encoder-decoder架构
- 其他注意点:多层LSTM,encoder-decoder架构在训练和实际预测时的不同、让大模型进行矩阵计算过程模拟,反向传播涉及矩阵微积分(我投降,我用维度分析法),梯度爆炸(我再投降,你能拿我咋滴)
下文遵循 “MLP(究极粗糙版) -> MLP(滑窗版) -> 传统RNN -> LSTM -> deep LSTMs ->encoder-decoder” 的顺序
MLP
场景设定为:对于一个序列/向量 比如 a cat sat on a ___ 这里要预测个词
对于MLP(究极粗糙版),需要将a cat sat on a转成5个词嵌入 5*(1, 300),然后拼接形成(1, 1500),然后经过隐藏层 (1, 1500) × (1500, 128) = (1, 128),最后输出层 (1, 128) × (128, 10000) ,这里假定10000个词,然后softmax看哪个词。
这里问题在于, 这里定长了,于是有MLP(滑窗版),假设窗口长度为3。若训练数据为“a cat sat on a mat” 则滑窗出 a cat sat (on)、cat sat on (a)、sat on a (mat) 来训练。预测时,只能利用最后三个词“sat on a”去预测 mat。
公式:
传统RNN
先看 RNN大白话讲解
场景依旧 “a cat sat on a ___”,传统RNN初始参数有:词嵌入表(冻结)(1e4, 300),隐藏层权重(428, 128),隐藏层偏置 (1, 128),输出层权重(128, 1e4),输出层偏置 (1, 1e4),其中 1e4 为“假设词汇表共个1e4个词”,128 是隐藏层神经元个数,300是词向量维度。
先将 a 转成词嵌入 (1, 300),与上个隐藏层结果(h_0设定为全0 (1, 128))拼接得到 (1, 428),经过隐藏层 (1, 428) × (428, 128) = (1, 128) = h1;cat转为词嵌入 (1, 300),与上个隐藏层结果得到 (1, 428),经过隐藏层 (1, 428) × (428, 128) = (1, 128) = h2 ;sat、on、a 类似;经过 a 后有 h5 = (1, 128),经过输出层 (128, 1e4),然后softmax后知道是哪个词。
训练时,h1h5都会经过输出层得出L1L5(语言建模) 或者 只在最后一个时间步产生一个输出和损失(情感分类),前者 总损失 通过求和 (或取平均),后者 总梯度(如对矩阵W_hh)通过传递:
公式:
LSTM
一句话就是,LSTM平时多传个变量“细胞状态”然后多弄几个参数矩阵相应地处理它。
理解传统RNN后看 LSTM大白话讲解 就能理解,不理解就再看RNN
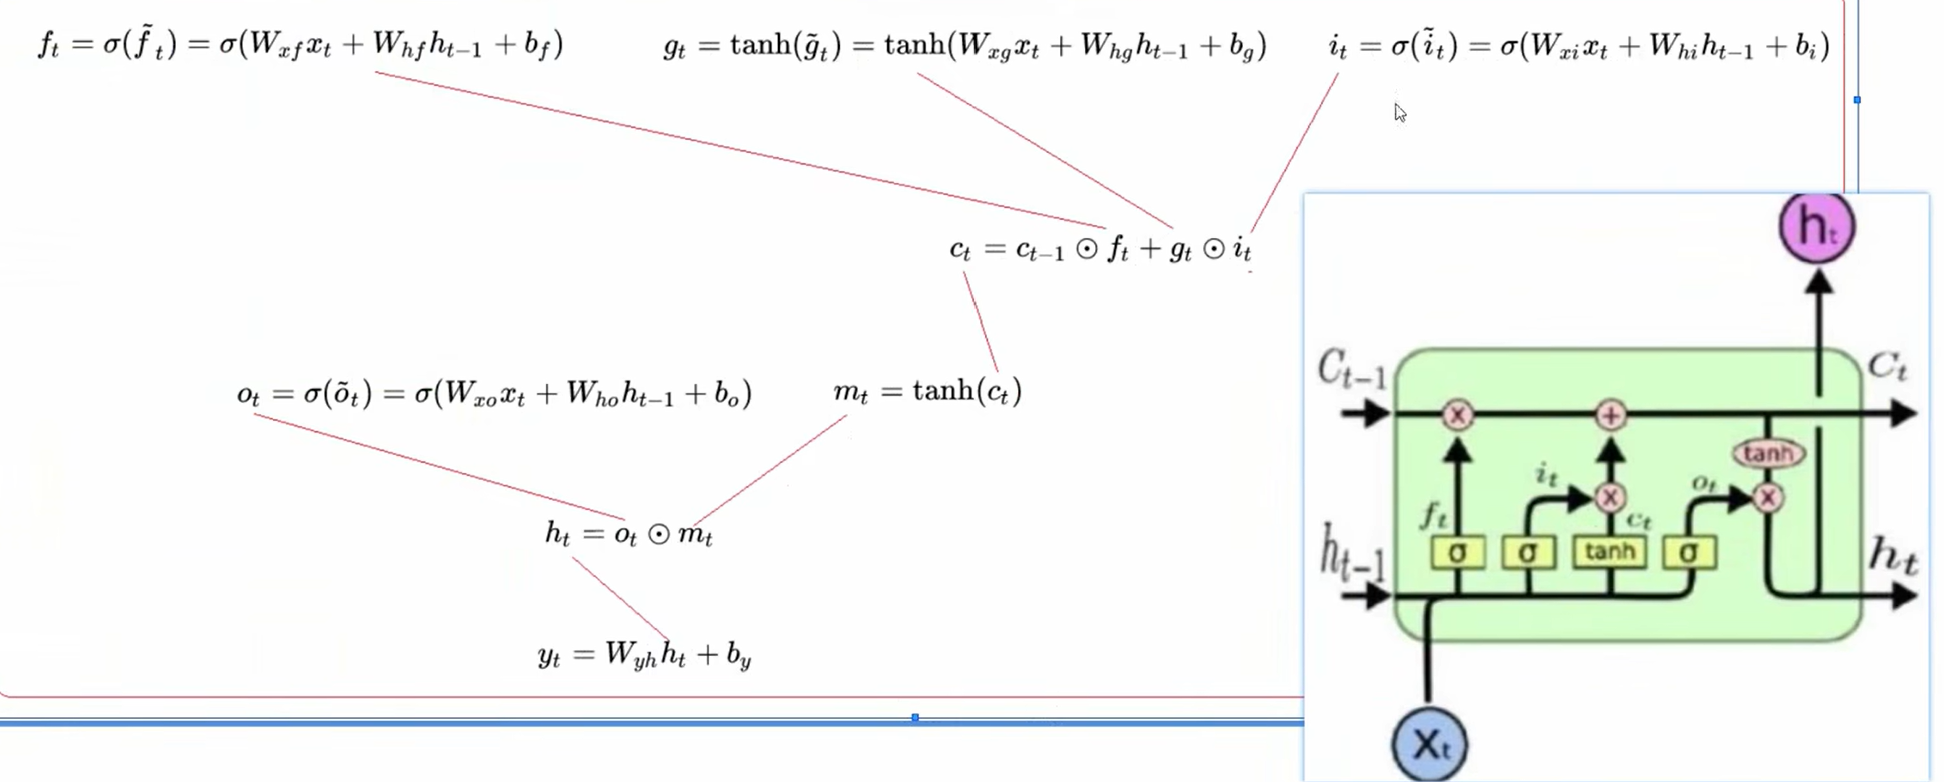
公式记忆 :一个 隐状态 ,一个 细胞状态,细胞遗忘 × σ,细胞更新 + (σ × tanh),新隐状态生成
视频里的公式讲解图如下
deep LSTMs
                               o_t ---> ...   (最终输出)
                                ^
                                |
      h3_t-1 ---> h3_t ---> h3_t+1  (第3层 - 最高层抽象)
         ^         ^          ^
         |         |          |
      h2_t-1 ---> h2_t ---> h2_t+1  (第2层 - 中间层抽象)
         ^         ^          ^
         |         |          |
      h1_t-1 ---> h1_t ---> h1_t+1  (第1层 - 底层特征)
         ^         ^          ^
         |         |          |
        x_t-1     x_t        x_t+1      (原始输入序列)
假设维度大小 —— 词向量(1,300) 隐藏状态(1,128),则第一层的某个权重矩阵大小为(300+128, 128),其他层(128+128, 128)。
encoder-decoder(Seq2seq)
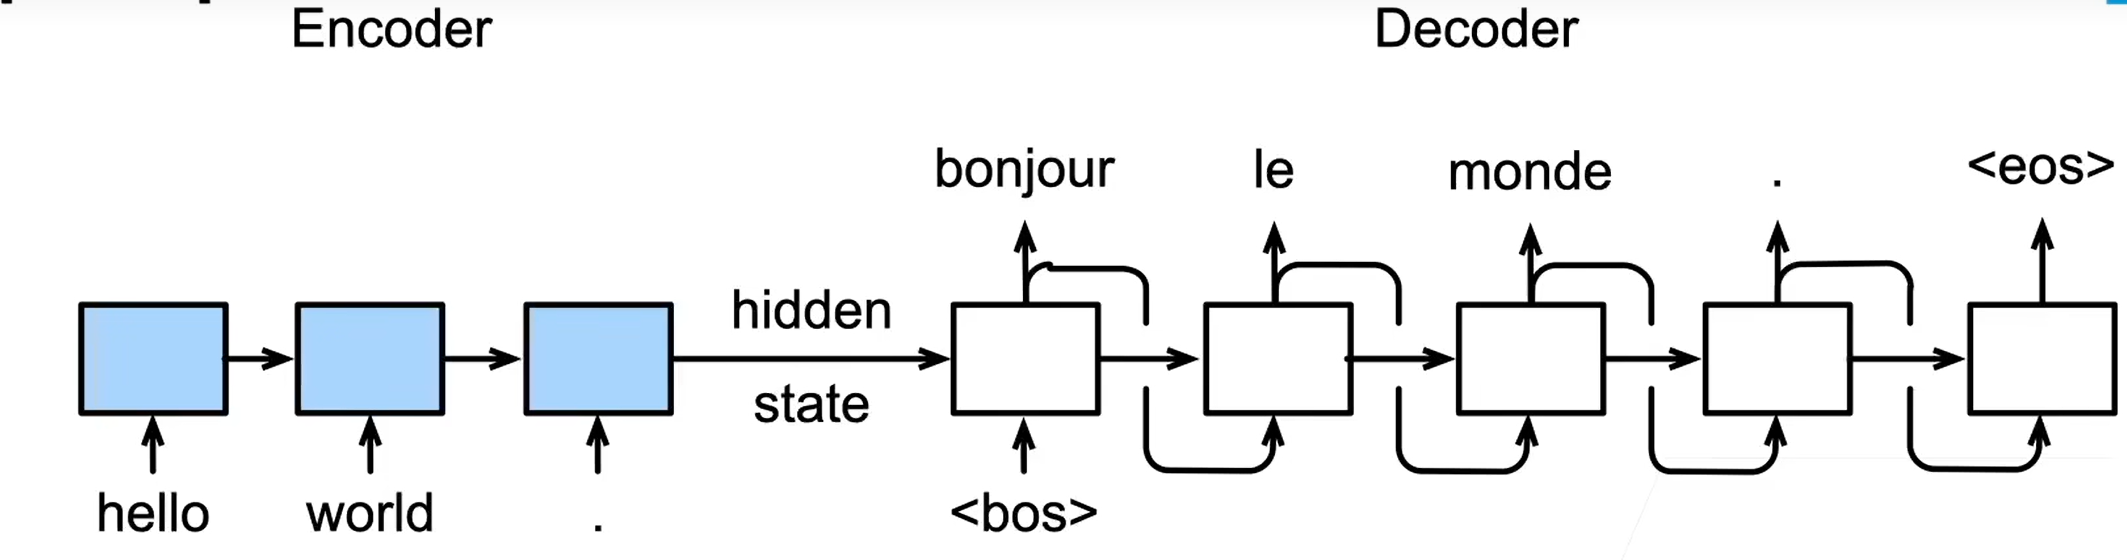
- 蓝色部分为encoder即一个LSTM,白色部分为decoder也是一个LSTM。
- encoder的隐状态作为decoder的,(预测时)给decoder一个“开始记号”为,第一个时间步里输出的词作为第二个时间步输入词,如果输出的词为,则结束
- 图中hello world .如果反着输入会有更好效果 —— “这点上我觉得是,解码器它(除t=1)后面的RNN层输入的词是 t-1 输出的词,而hello 最后进入,t=1 当然更容易是hello 相关,这样t=2也更正确,后续亦如此”
- Seq2seq论文中使用4层深度的 deep LSTMs,也就是作为输出
- 训练时,在decoder这里会保证每个时间步输入的都是对的词,以调整参数
Bahdanau Attention
Bahdanau /bɑːdˈɑːnaʊ/ ,“吧嗒脑”注意力, 加法注意力
链接与要点
**要点:**双向RNN,论文中的注解、 的 c 的固定传入、 的 的产生与作用、**加性注意力机制 ** (对应于论文中的计算)
提示词积累:
把相关公式全部一次性列出”、
这些公式一行用原公式,一行用具体矩阵(m, n)× 这样的方式呈现,注意公式的成功显示
核心公式概览

假设我们在时间步 t 解码目标词 ,此时传入前一步的隐藏状态,编码器的所有注解是 。(注解的概念需结合双向RNN,一句话就是“biRNN产生的“同词隐状态”拼接”)
计算能量分数 (Energy Score): 说白了一个向量反映 与 的匹配程度。
计算注意力权重 (Attention Weights): 说白了 Softmax。
计算上下文向量 (Context Vector): 说白了 叉乘 注意力向量。
计算解码器新状态 (Decoder Hidden State): 生成当前时间步隐状态。
预测目标词概率 (Output Prediction):
设定具体维度
为了让矩阵的尺寸更加清晰,我们首先设定一组具体的、符合常规的维度值:
- RNN隐状态维度 ():
128 - 编码器: 双向RNN (BiRNN),隐状态维度: 128
- 编码器注解维度 ():
256- 因为是双向RNN,每个时间步的注解 是由前向状态 和后向状态 拼接而成,所以 。
- 解码器隐状态维度 ():
128- 论文中设定解码器RNN的隐状态维度与编码器单向RNN的隐状态维度相同。
- 注意力机制隐维度 ():
64(这是一个超参数,可以自己设定) - 词嵌入维度 ():
100 - 源句长度 ():
10(比如 “I am a student from China”) - 目标词汇表大小 ():
10000
分步公式与维度详解
1. 计算 e
原始公式(加性注意力):
向量化形式:
- (解码器状态) 是一个
(128, 1)的列向量。 - (编码器所有注解) 是一个
(256, 10)的矩阵,每一列是一个 。 - 计算结果为
(64, 1)。 - 计算结果为
(64, 10)。 - 加法时,
(64, 1)的向量被广播成(64, 10)的矩阵,与(64, 10)的矩阵相加。 - 最终,
(1, 64)乘以tanh后的(64, 10)矩阵,得到(1, 10)的能量分数行向量 。
2. 计算注意力权重 α
维度详解:
- Softmax函数作用于行向量
(1, 10)的每一个元素上。 - 输出的 仍然是一个
(1, 10)的行向量,其中每个元素 都在0到1之间,且所有元素之和为1。
3. 计算上下文向量 c
维度详解:
- 我们将注意力权重行向量
(1, 10)转置为列向量(10, 1)。 - 然后用编码器注解矩阵
(256, 10)乘以这个权重列向量。 - 这个矩阵乘法完美地实现了加权求和的功能,得到了一个维度为
(256, 1)的上下文向量 。
4. 计算隐状态 s
通用公式:
维度详解:
注解:
- 是上一步预测的词的ID,通过一个嵌入层 变为词嵌入向量 ,维度为
(100, 1)。 - 将词嵌入向量
(100, 1)与上下文向量(256, 1)拼接 (concatenate) 起来,形成RNN的实际输入input_i,维度为(100 + 256, 1) = (356, 1)。 - 解码器的RNN单元接收上一个隐状态
(128, 1)和这个新的输入input_i(356, 1),经过内部运算后,输出新的隐状态 ,维度依然是(128, 1)。
5. 预测目标词概率 P(y)
通用公式:
(原论文中 g 是一个带有Maxout的深度输出层,这里简化为常见的线性层+Softmax)
维度详解:
注解:
- 将上一步的词嵌入
(100, 1)、当前解码器状态(128, 1)和上下文向量(256, 1)三者拼接。 - 拼接后的向量维度为
(100 + 128 + 256, 1) = (484, 1)。 - 这个向量通过一个大的输出线性层(权重矩阵 尺寸为
(10000, 484),偏置 尺寸为(10000, 1))进行变换。 - 变换结果是一个
(10000, 1)的向量,称为 logits。 - 最后,对 logits 应用Softmax函数,得到词汇表中每个词的概率分布向量 ,维度为
(10000, 1)。概率最高的那个词就是我们这一步的最终预测结果。
反向传播
可视化梯度流:
Transformer
链接、要点与思考
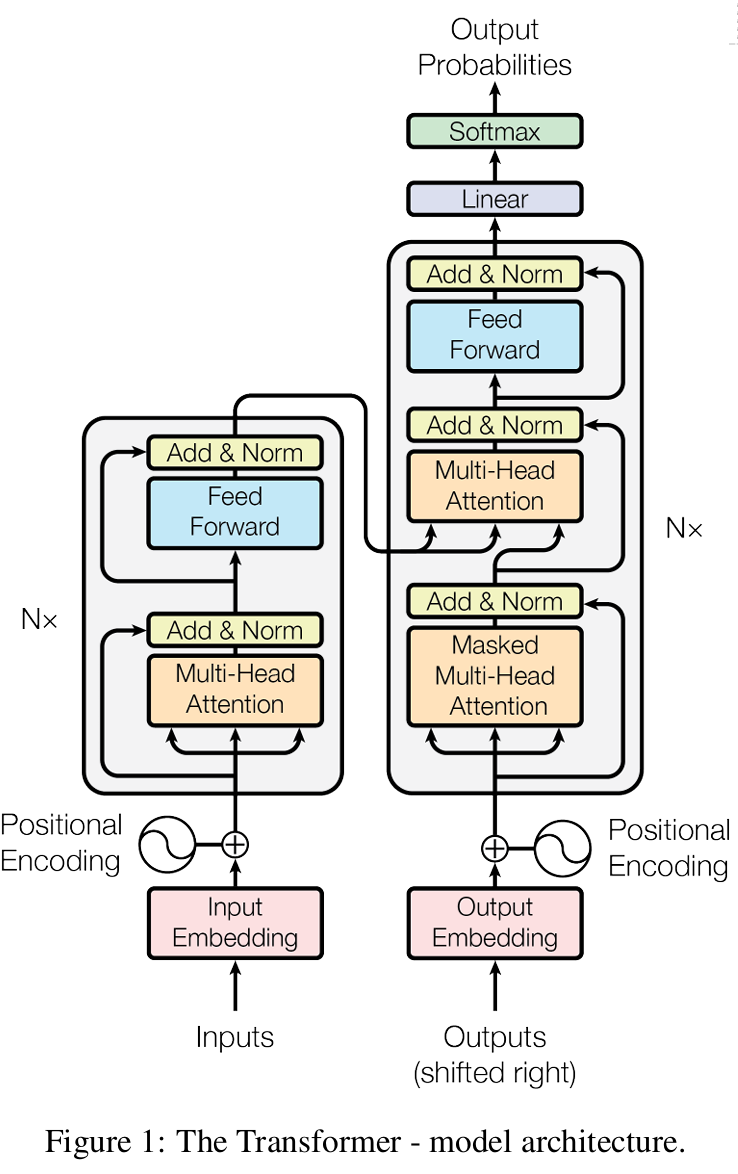
链接:深入浅出:用中学数学理解Transformer模型(必看)、李宏毅 | 自注意力机制和Transformer详细解析(必看)、李沐自注意力
要点:自注意力机制思想、点积注意力公式、transformer架构、因果mask实现并行
思考与拓展:理解完全部组件再回过头,encoder就是将原始输入序列进行一个上下文关联化,它的输出类似RNN原序列里的各个隐藏层状态(h_1…h_n),训练时decoder则通过因果mask,使得每个正确答案token都受到上文关联化,然后每个token的loss能并行获取到,预测时则串行地从仅输入<s>开始,每次都从最后一个token去获取下一个词,直到遇到</s>。拓展源自李宏毅视频,比如 guided attention 比如 beam tree 比如 训练和预测时加入噪音 比如 用blue score计算损失时无法求偏导用RL硬刚 比如 scheduled sampling类似训练时加入噪音(模拟预测时预测到错误)增强鲁棒性
**总结:**encoder —— self-attention(“self” MHA+add&norm+FFN+add&norm), decoder —— cross-attention (masked MHA + add&norm + “cross” MHA + add&norm + FFN + add&norm)
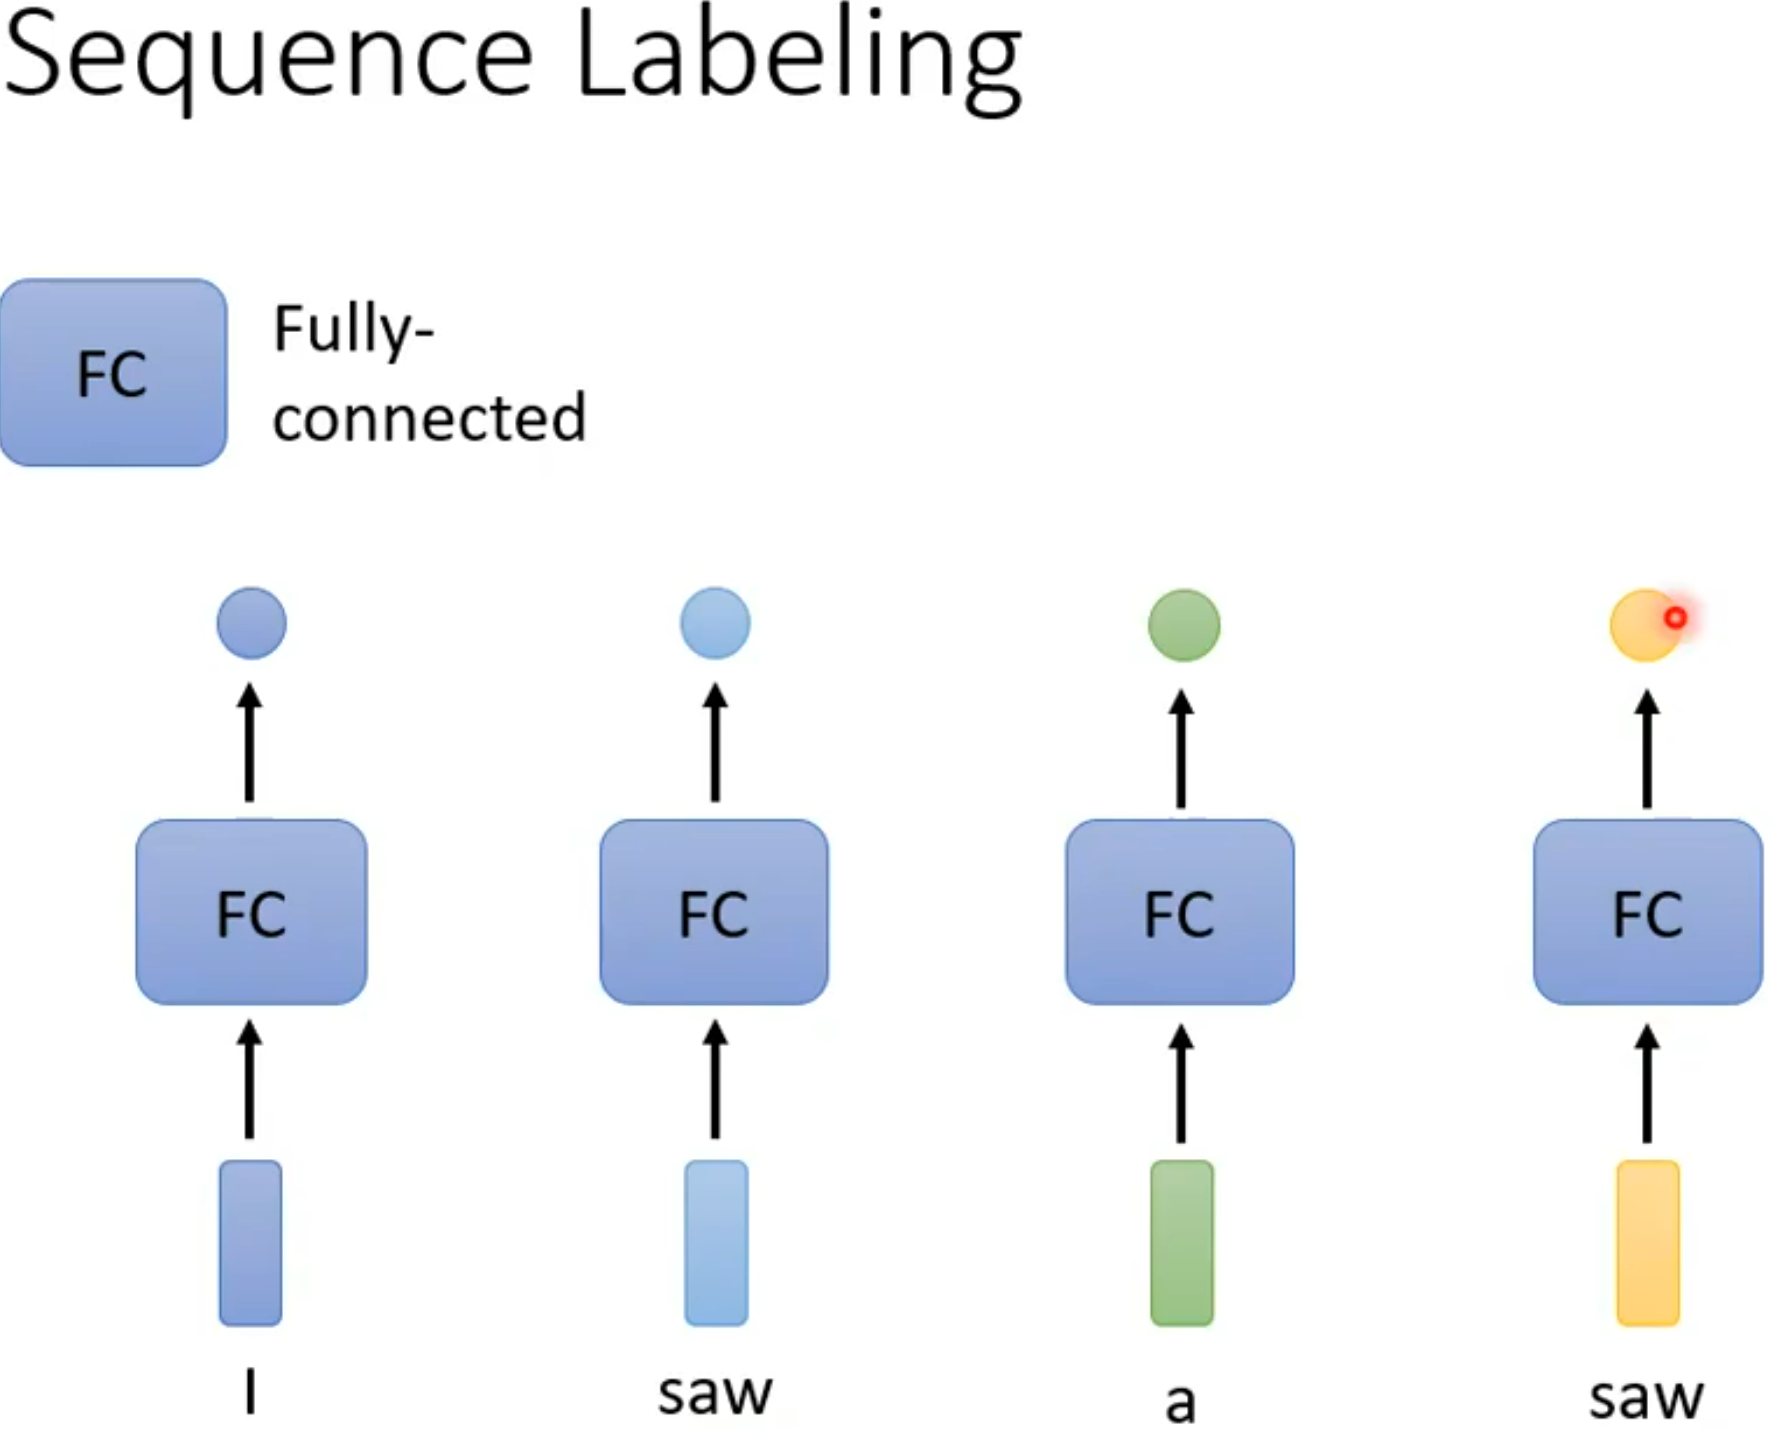
引入
没有上下文信息的labeling,这样两个saw必然输出相同词性
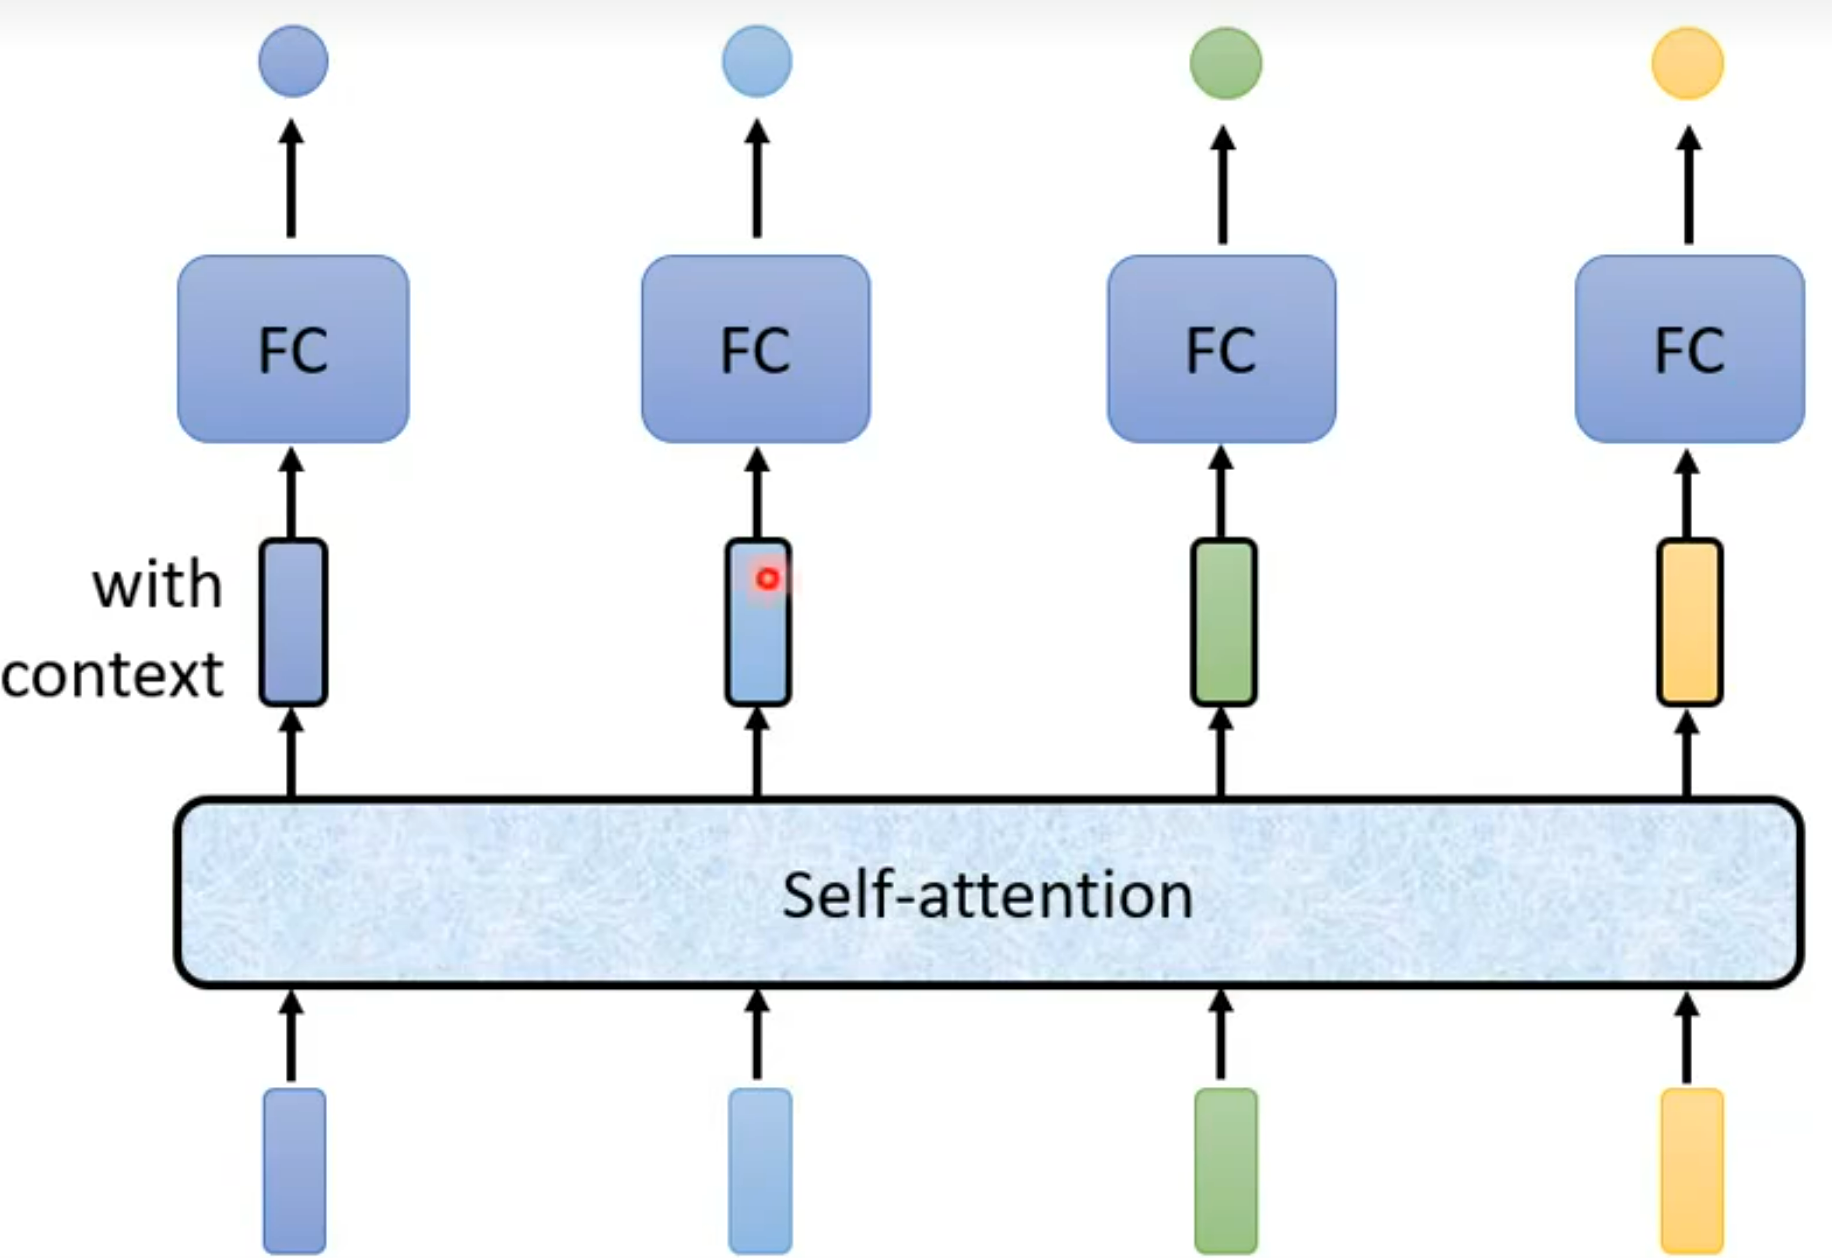
给个窗口,拼接窗口内向量作为输入,提供上下文信息
没有考虑全文,无法变长,参数量大

自注意机制后的向量有上下文信息,由参数矩阵分配,可变长且全局。
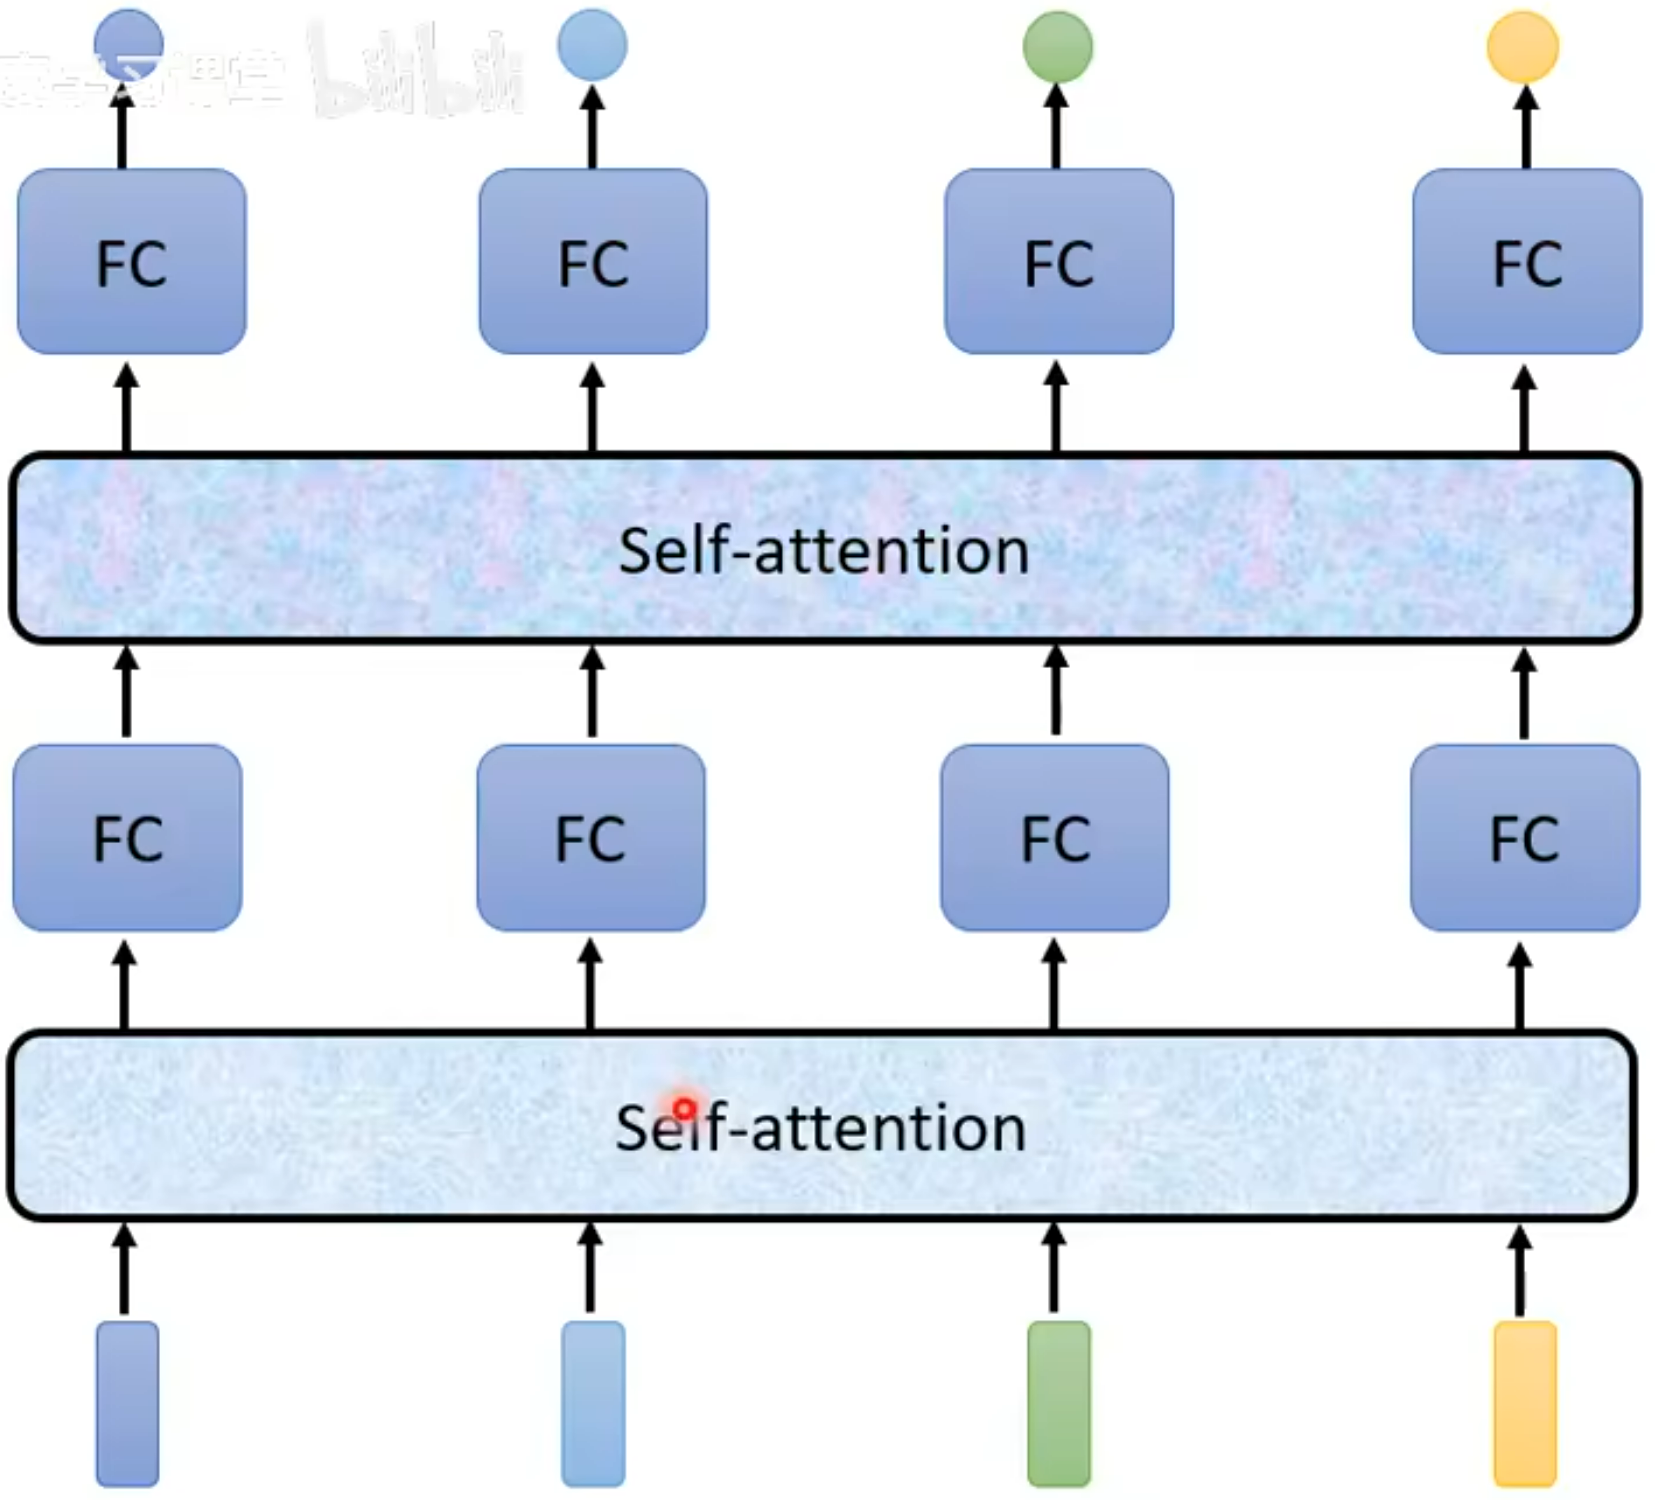
可多层“self-attention + FC”
自注意机制模块
衡量两个词之间的“相关度”——点积(外积)
绿色方框词向量分别为 ,此处可以得出词向量的“相关度”,具体来说: 的每个值 和 的 相关度向量 concat 形成 矩阵(外积) ,公式如下, 是 k 的维度( q k 维度一样大),过除以 ,可以将点积的方差稳定在 1 左右,使其大小不受向量维度 的影响。
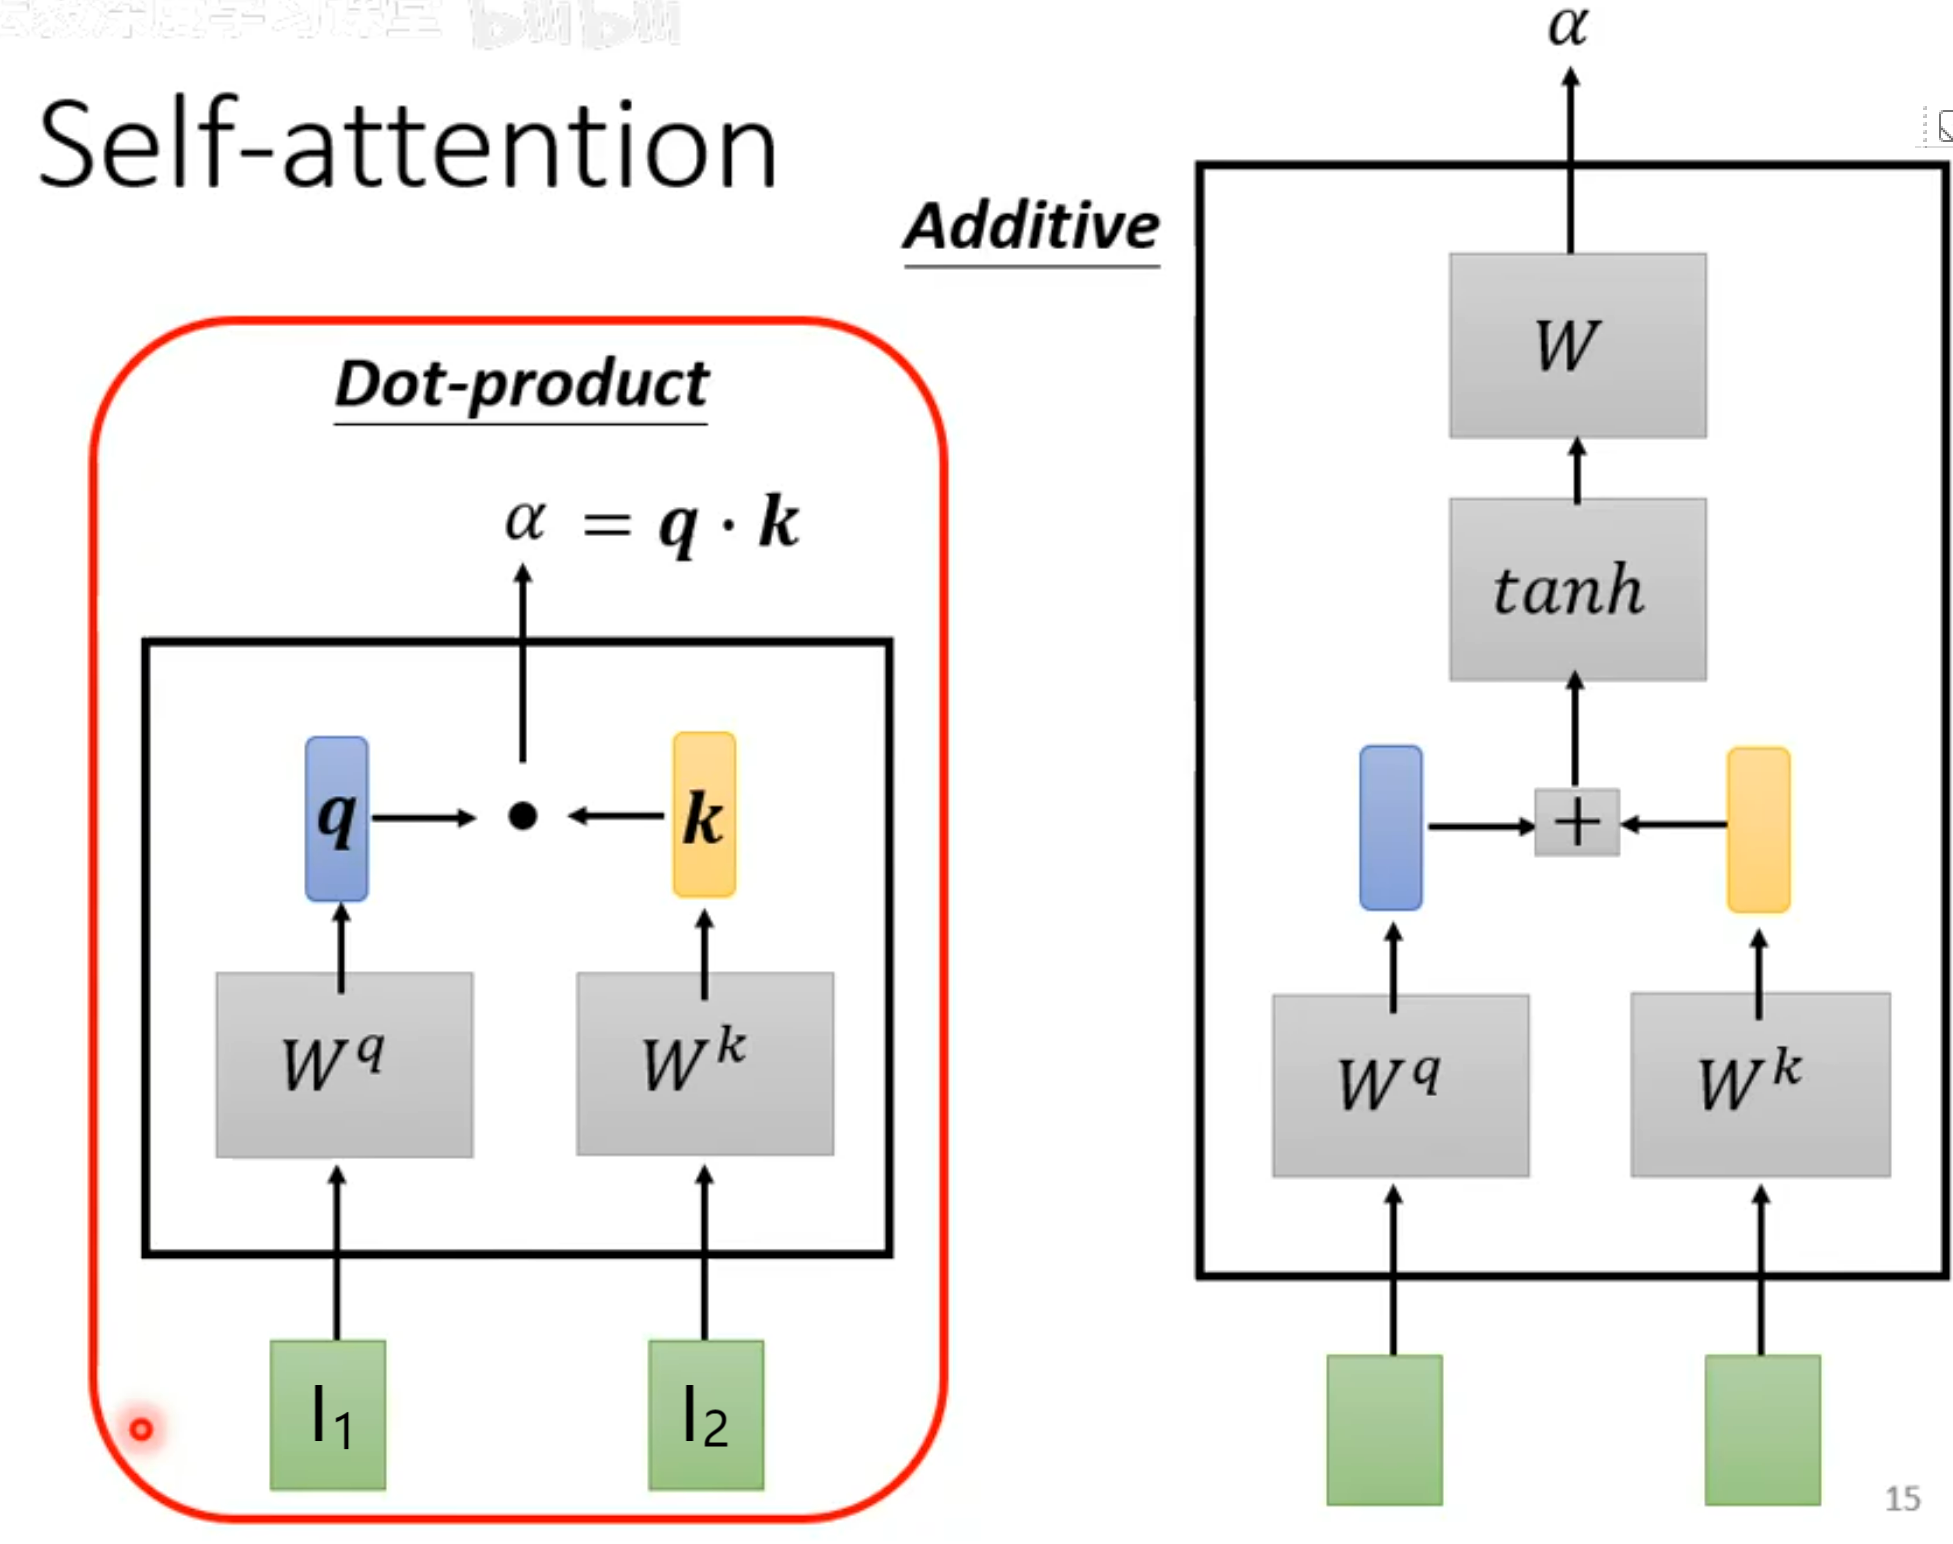
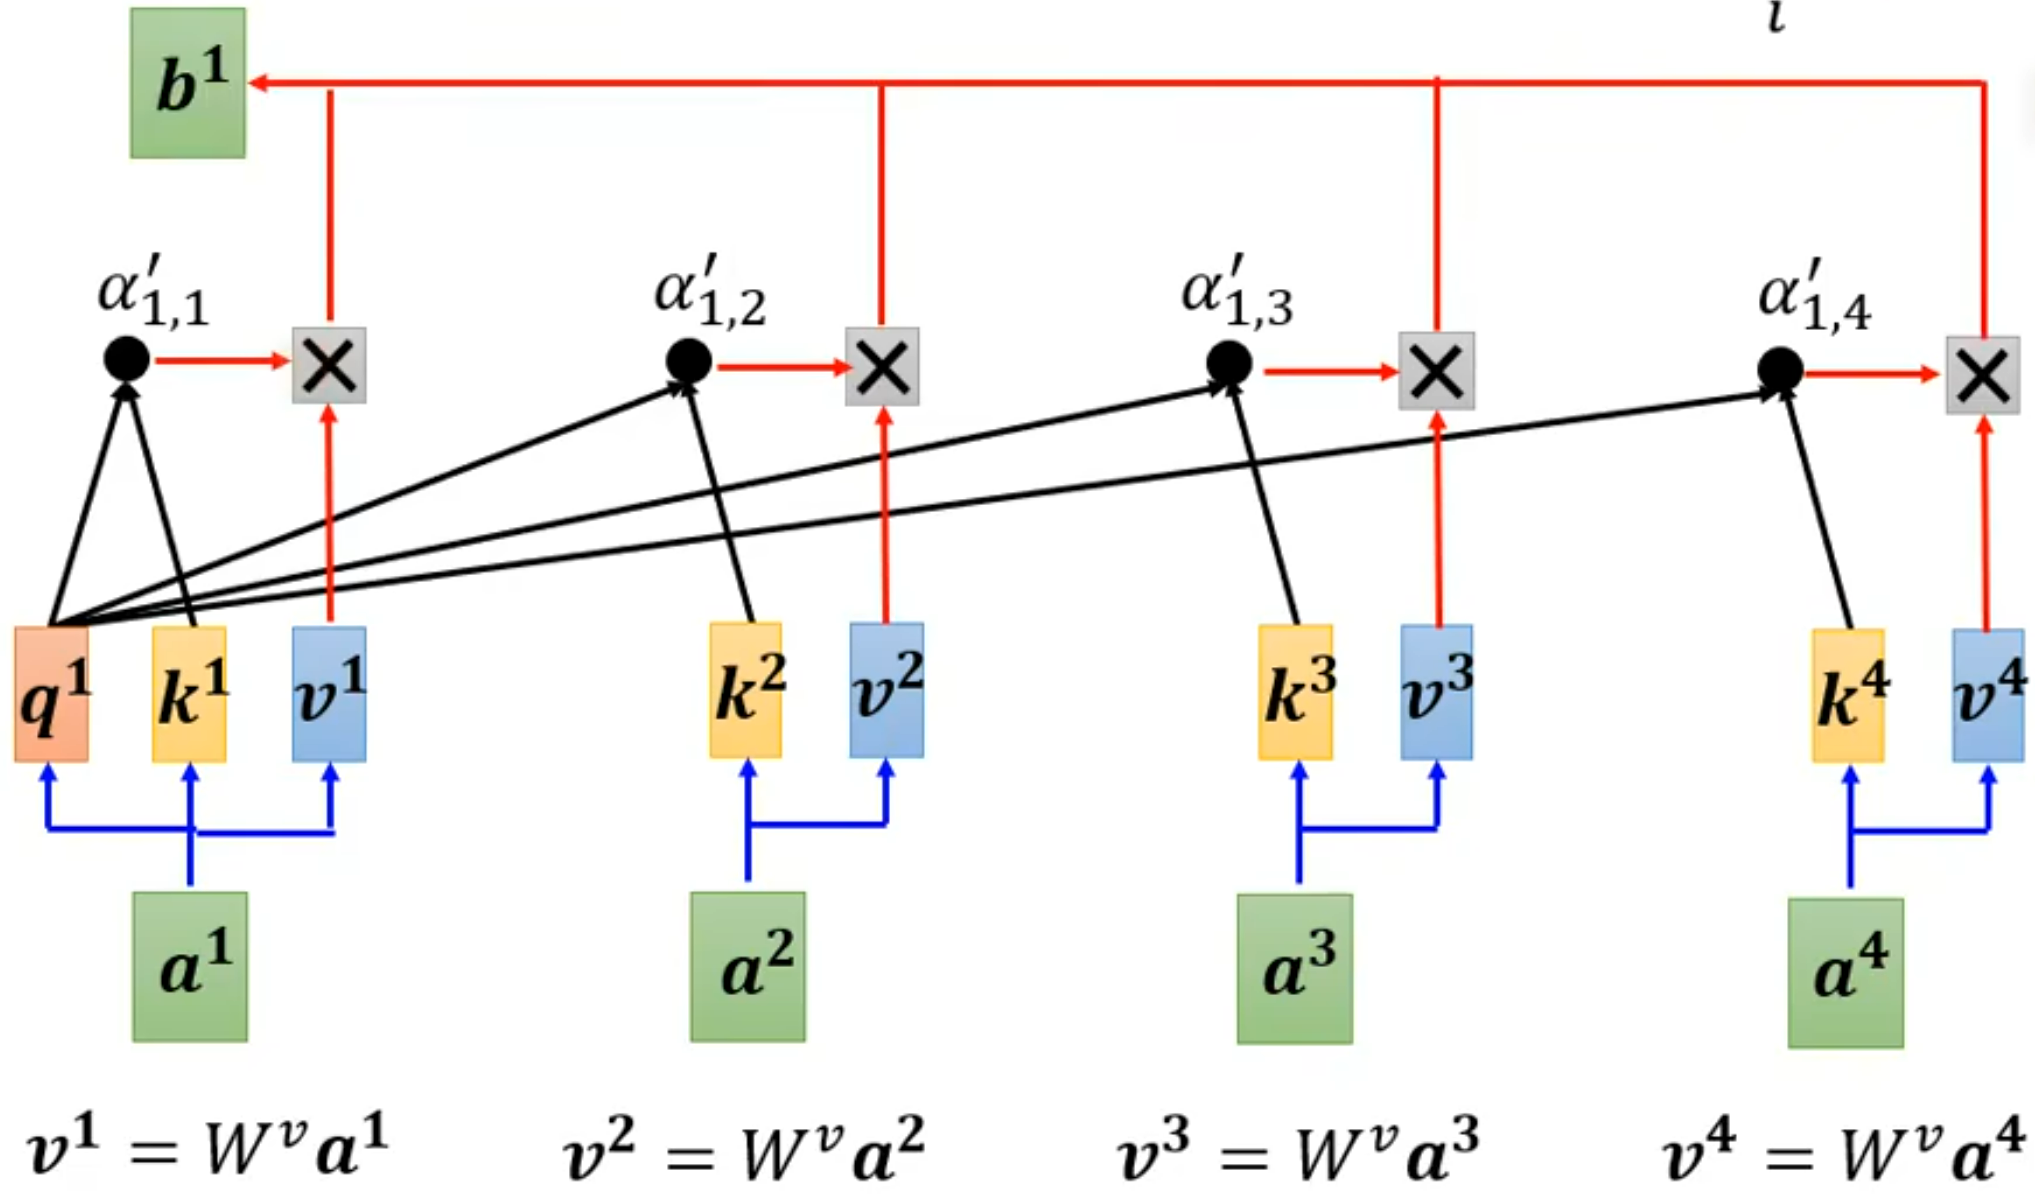
假设输入序列为 ,输出序列为 。
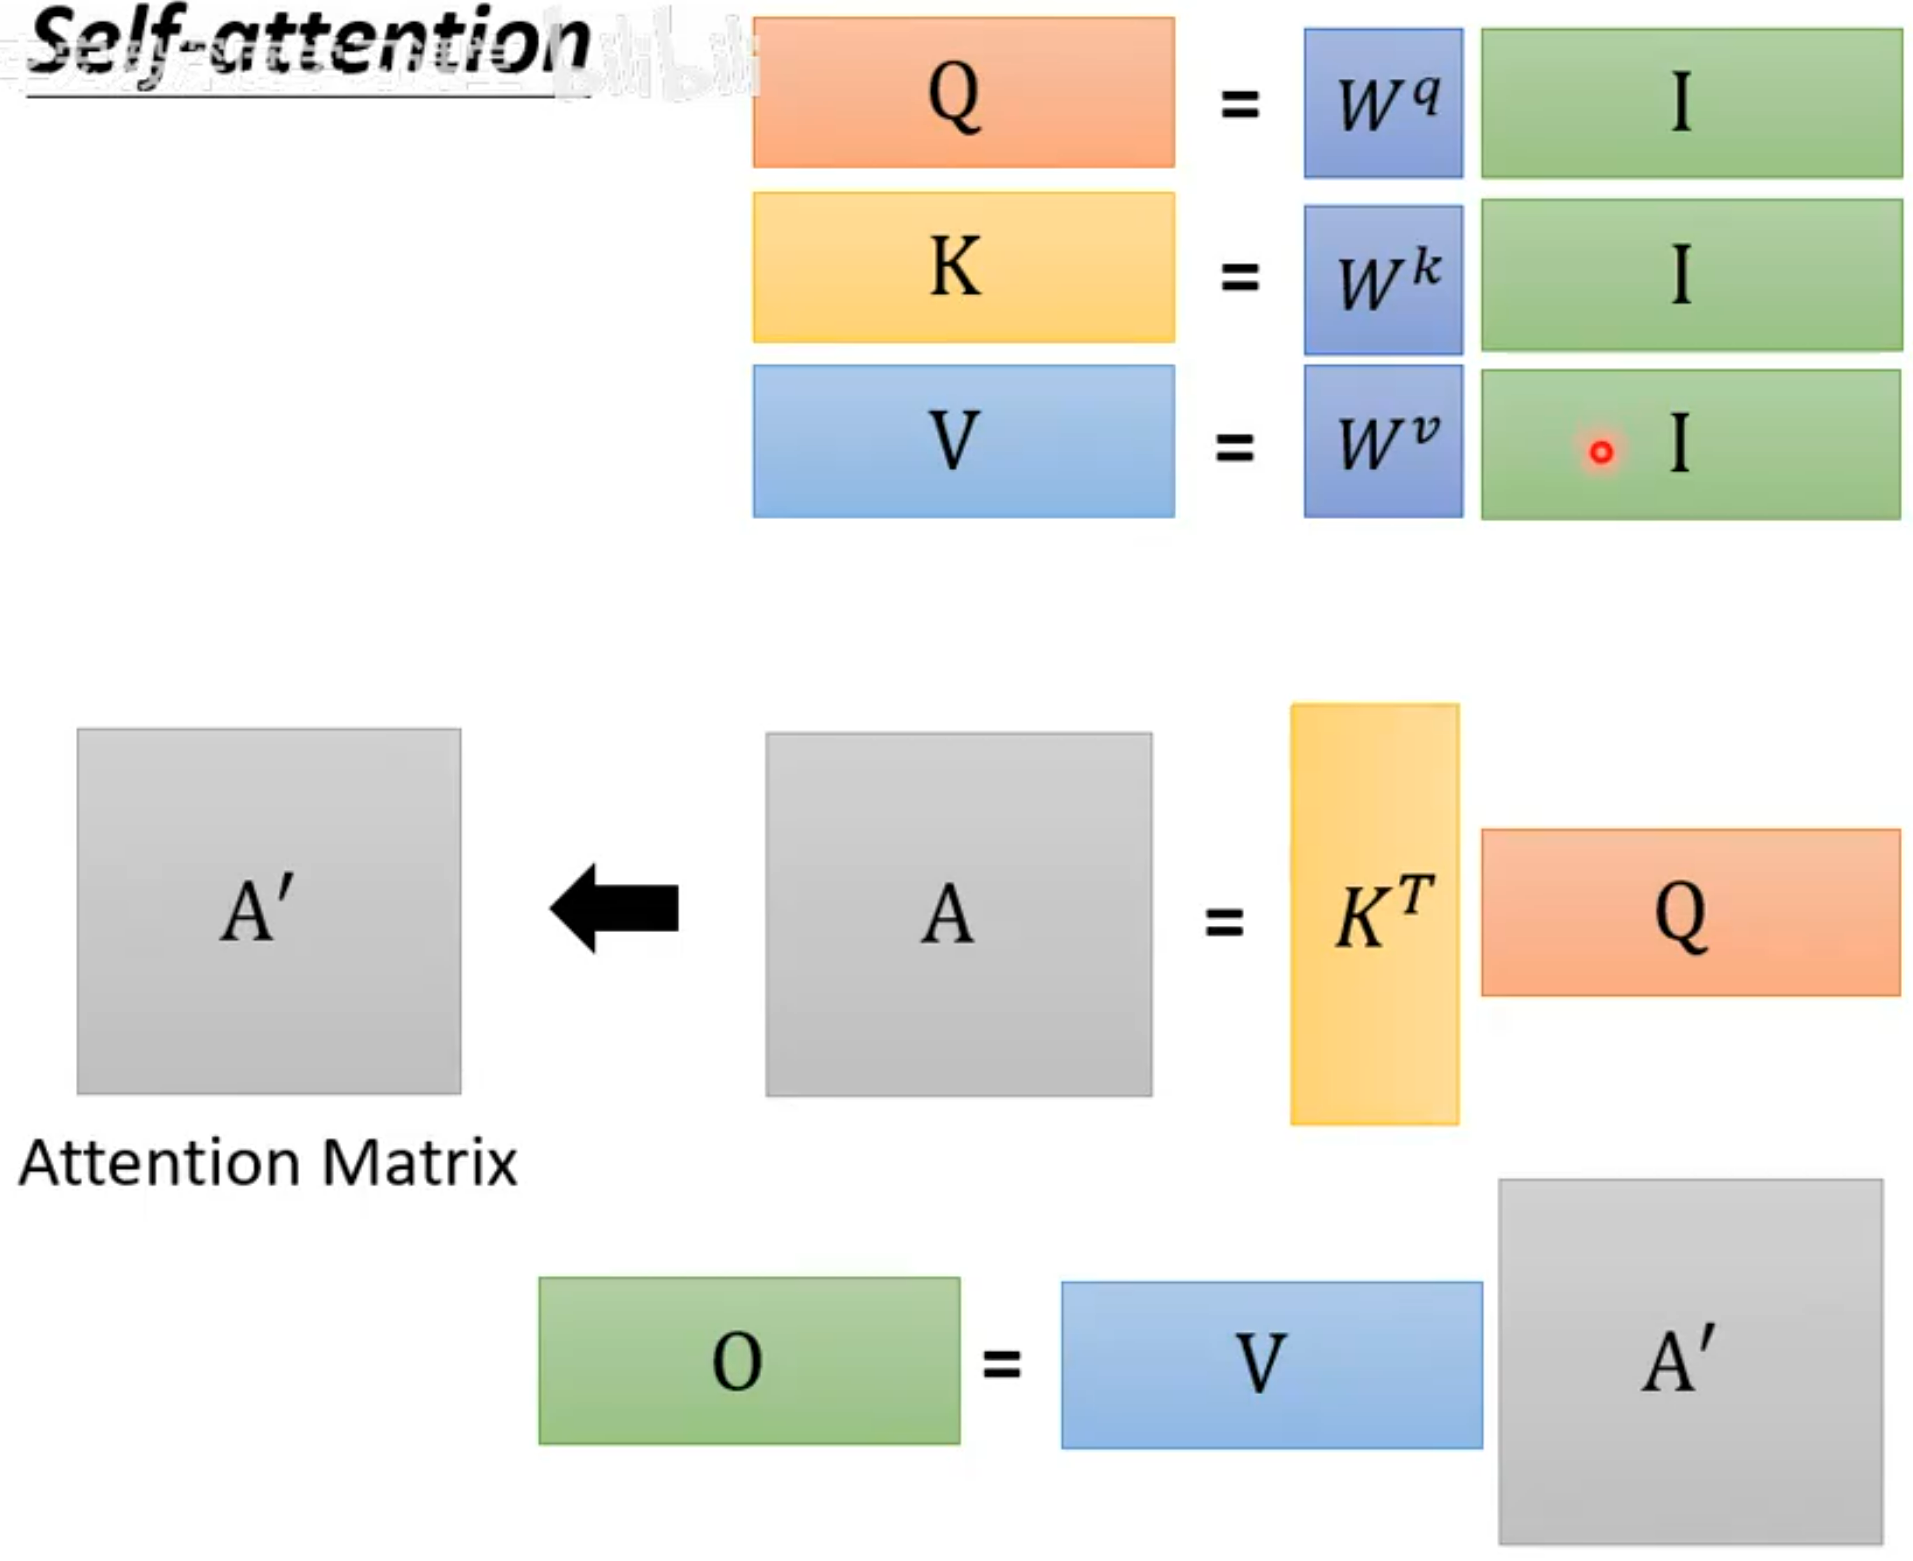
生成Query, Key, Value: 对于每个输入向量 :
计算注意力权重: 计算第 个输出 时,需要用它的查询 和所有的键 计算相关性得分,然后通过Softmax进行归一化。
用我的话说:A的长度个 “描述相关性”的 向量,第 i 个向量描述 如何由 加权得来
计算输出向量: 将权重 与对应的 加权求和,得到输出 。
位置编码
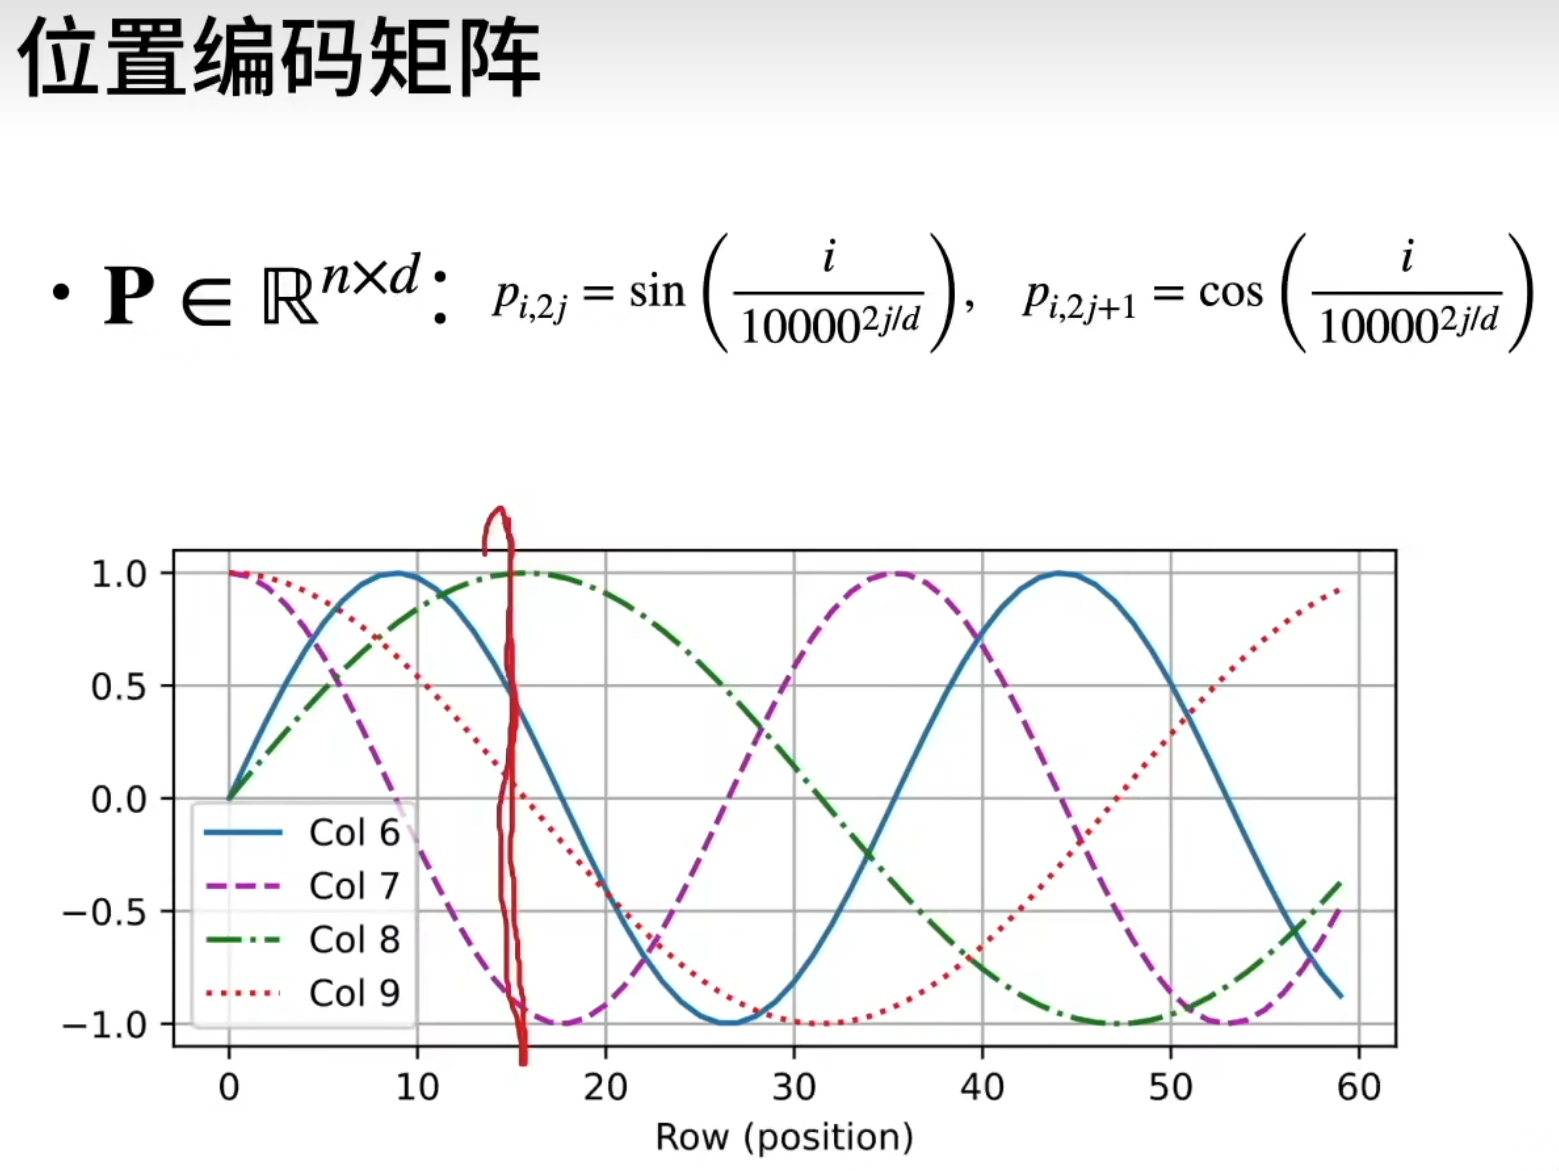
这里是一个位置编码例子(来自)发现2j和2j+1的区别是sin和cos,也就是说:对第 i 个向量进行编码 第0,1维变化是 “+b” (sin(wx+b)里),即平移;第0,2维变化是 “w+1”,即伸缩。
维度稍微大点,如300,就几乎能确保 同向量里 位置编码 不重复(把这个几个sin cos 用傅里叶变换 可以变成一个新的 sin,所以是有周期性的)。
这个编码的好处是,有个“相对性”变换,直接不停地对前一个位置乘矩阵就行。 $$ \begin{bmatrix} \cos(\delta\omega_j) & \sin(\delta\omega_j) \ -\sin(\delta\omega_j) & \cos(\delta\omega_j) \end{bmatrix} \begin{bmatrix} p_{i,2j} \ p_{i,2j+1} \end{bmatrix}
\begin{bmatrix}
p_{i+\delta,2j} \
p_{i+\delta,2j+1}
\end{bmatrix}
$$
transformer-encoder
拆解并量化 Transformer 的每一个步骤,将设定一些具体的维度值,这些值与原始论文《Attention Is All You Need》中的设定类似。
设定参数
输入序列长度 (Sequence Length): 。例如,输入一句话 “I am a robot”。
词嵌入维度 (Embedding Dimension): 。这是模型中大部分向量的维度。
注意力头数 (Number of Heads): 。
每个头的维度 (Dimension per Head): 。
前馈网络中间层维度 (Feed Forward Inner Dimension): 。
(关于头的维度:让他们关注不同的“子空间”(subspace),我们不给每个“头”完整的512维信息,而是把这个信息“切分”成8份。每一份是64维(
512 / 8 = 64)。这样,每个“头”就只能在自己被分配到的64维信息空间里去学习和计算注意力。)
嵌入层和位置编码
Embedding & Positional Encoding,假设我们有一个长度为 4 的输入序列。
Input Embedding: 首先,我们将每个词(token)通过一个嵌入层(本质上是一个查找表)转换成一个向量。
- 输入: 4 个词的 ID。
- 输出: 一个矩阵 , (即 ),代表了每个词的语义嵌入。
Positional Encoding: 我们生成一个与 相同维度的位置编码矩阵 ,然后和词嵌入逐元素相加,得到进入 Encoder Block 的最终输入矩阵 。
- 维度: 。
- 维度: 。
1. MHA
标准的 Multi-Head Attention (MHA)是 Encoder 的第一个核心子层。它的输入是矩阵 。
3.1 生成 Q, K, V 矩阵
通过将输入 与三个不同的权重矩阵 相乘来实现,也就是完整的K Q V。
输入:
权重矩阵:
- (注意: , , 的维度都是 )
矩阵运算:
输出: 。
3.2 拆分成多个头
接下来,我们将 矩阵在最后一个维度(512)上拆分成 8 个头,每个头的维度是 64。
操作: Reshape 和 Transpose。将 变为 ,然后交换头和序列长度的维度,方便后续计算。
(即 )
3.3 计算缩放点积注意力 (Scaled Dot-Product Attention)
这一步 每个头独立进行 的,以其中一个头为例,其输入 的维度都是 。
计算得分 (Scores):
这个 的矩阵表示序列中每个词对其他所有词(包括自己)的注意力原始得分。
缩放 (Scale):
逐元素除法,仍为 。
Softmax: 对得分矩阵的每一行应用 Softmax,得到注意力权重矩阵 。
的每一行元素相加为 1。
加权求和: 将权重矩阵 与 相乘。
就是这个头计算出的结果。
3.4 合并多头结果
Concat 和 Reshape。
- 将 8 个 的矩阵在最后一个维度上拼接,得到一个拼接后的 的矩阵
3.5 最终线性变换
将拼接后的矩阵 通过最后一个权重矩阵 进行线性变换,得到多头注意力的最终输出。
- 权重矩阵:
- 矩阵运算:
2. Add & Norm - 1
残差连接与层归一化,这一层连接在 Multi-Head Attention 之后。
4.1 Add (残差连接)
将 Multi-Head Attention 层的输入 与其输出 逐元素相加。
- 维度: 。
- 作用: 缓解信息丢失。
4.2 Norm (Layer Normalization)
在特征维度上进行归一化,相当于一个词向量内部进行归一化。
输入: 。
操作: LN 会独立地对矩阵中的 每一行 (每个词向量) 进行操作。我们以第一行向量 为例:
- Mean: 计算向量 中所有 512 个元素的均值 。
- Variance: 计算向量 中所有 512 个元素的方差 。
- 归一化 (Normalize): 对 的每个元素进行归一化。 是一个很小的数(如 ),防止分母为零。
- 缩放与平移 (Scale and Shift): 将归一化后的向量乘以可学习的缩放参数 (gamma) 并加上平移参数 (beta)。这两个参数的维度也是 ,它们在模型训练过程中学习,让网络可以恢复或调整归一化后的特征表示。
LN 对输入的 矩阵的 每一行 都执行上述步骤,最终输出一个维度同样为 的矩阵,我们称之为 。
3. FFN
这是 Encoder 的第二个核心子层,它是一个简单的两层全连接网络,被称为 Position-wise Feed-Forward Network,你可以把它想象成对 矩阵的每一行向量(512维)都应用了同一个 512 -> 2048 -> 512 的双层 MLP。
- 输入: 。
- 结构:
- 第一个线性层(扩展维度)
- ReLU 激活函数
- 第二个线性层(缩减维度)
- 权重矩阵:
- (即 )
- (偏置)
- (即 )
- (偏置)
- 矩阵运算:
我们分解来看:
- 。
- 仍为 。
- 。
- 输出: 。
4. Add & Norm - 2
与 Part 1 完全相同,只是输入不同。
Add: 将 Feed Forward 层的输入 与其输出 相加。
Norm: 对 的每一行进行层归一化。
这个 就是一个 Encoder Block 的最终输出。它可以作为下一个 Encoder Block 的输入,重复上述所有步骤 N 次。
transformer-decoder (推理)
场景设定
一些继续使用之前 Encoder 的设定:
- 词嵌入维度:
- 注意力头数:
- 每个头的维度:
- 词汇表大小 (Vocabulary Size): (用于最后的 Linear+Softmax)
假设 Encoder 已经运行完毕,输出了一个矩阵 (对应 “I am a robot” 的 4 个词)。
现在我们开始 Decoder 的预测过程,目标是生成 “我 是 一 个 机器人”,时间步 t=3 (假设已经生成了 “我 是”)
- Decoder 输入:
<s>“我” “是”,序列长度为 3。 - 矩阵维度: (经过 Embedding 和 Positional Encoding)。
1. Masked MHA
输入: 。
Q, K, V 生成:
多头注意力计算 (以单头为例,输入 ):
Scores:
Masking & Softmax: 将得分矩阵的上三角部分(不含对角线)设为 。
- 注意力得分矩阵 ():
- 应用掩码后:
- 经过 Softmax 函数后:
加权: 。
合并与输出: 经过拼接和最终线性变换,得到 。
2. Add & Norm - 1
- Add:
- Norm:
3. (Cross attention)MHA
Encoder-Decoder Attention (cross attention),这是关键的交互步骤,一句话就是:根据 掩码自注意后的输入序列信息 动态汲取encoder输出的全局信息。
Query (Q): 来自 Decoder 上一层的输出 。(Q是多少 token 决定了后边会输出多少 token)
Key (K) 和 Value (V): 来自 Encoder 的最终输出 。
矩阵运算:
多头注意力计算 (以单头为例):
- Scores:
- 这个 的矩阵代表 Decoder 当前的 3 个词分别对 Encoder 的 4 个输入词的关注度。
- Softmax: 得到权重矩阵 。
- 加权: 。
合并与输出: 。
4. Add & Norm - 2
- Add:
- Norm:
5. FFN
- 输入:
- 运算: 与 Encoder 中的 FFN 完全一样。
- 维度变化:
- 输出:
6. Add & Norm - 3
- Add:
- Norm:
这个 会作为下一个 Decoder Block 的输入,重复上述 1 - 6 过程 N 次,也就是和encoder内容交互N次。
7. final layer
Final Linear & Softmax,在经过 N 个 Decoder Block 后,我们得到最终的输出矩阵 。因为我们只关心下一个词的预测,所以我们只取这个矩阵的最后一行向量 (对应输入 “是” 的位置)。
- Linear: 将这个 512 维的向量通过一个线性层,映射到词汇表大小的维度。
- 权重:
- 运算:
- Softmax: 将 Logits 转换成概率分布。
模型会从这个概率分布中选择概率最高的词(比如 “一”)作为下一个词的输出,然后进入 时间步 t=4 的循环。
transformer-decoder (训练)
训练中所有标准答案token的预测是在一次前向传播和一次反向传播中并行完成的,而不是多次独立的传播,和预测推理对比
- 训练时: 并行处理,一次前向+一次反向,完成整个序列的学习。
- 预测时: 串行处理,一次生成一个词,循环多次。
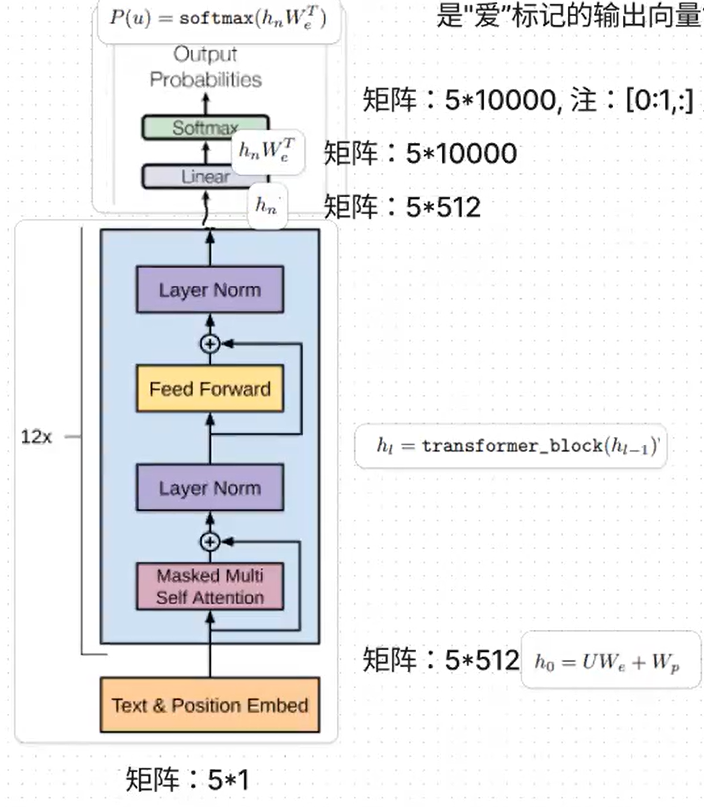
1. 准备数据
一条训练样本 = 原始输入 + 标准答案,假设一条 SFT 训练样本为:
输入:
你是谁?

标准答案:
<s> 我 是 一 个 机器人
拼接:
你 是 谁 ? <s> 我 是 一 个 机器人假设:
- 整个序列长度:
- hidden size:
- 头数:
- 每个 head:
2. 一次前向传播
Embedding层
Causal Mask MHA
- Q、K、V
同理:
拆成 8 个 head:
单独看一个 head:
维度:
所以:
这一个 矩阵的 10 行分别对应 10 个不同位置。
- Casual Mask
加入 Causal Mask 因果掩码:
得到:
维度不变:
- Softmax、V、Masked MHA 输出
单个 head 输出:
8 个 head:
Concat:
再经过 :
所以:
其中掩码后边解释,其作用理解如下
H[4] → “你是谁?<s>” 的上下文表示
H[5] → “你是谁?<s>我” 的上下文表示
H[6] → “你是谁?<s>我是” 的上下文表示
H[7] → “你是谁?<s>我是一” 的上下文表示
H[8] → “你是谁?<s>我是一个” 的上下文表示
然后是decoder block其他组件,见前文,add&norm FFN add&norm … final
3. 一次损失计算
| |
前向传播仍然会得到整条序列的:
经过 final layer:
所以, V 是 token 种类数比如3万
但是 SFT 时,不是 10 个位置都算 loss,序列是:
| |
那么 labels 工程上类似:
| |
其中 -100 通常表示:这个位置在 CrossEntropyLoss 中忽略,不计算 loss。
所以真正参与损失的可以写成:
即
| |
4. 一次反向传播
我们根据这个单一的损失值,进行一次反向传播,计算所有模型参数( 等)的梯度,并更新它们。
5. 因果掩码
- Masked Multi-Head Attention**: 在注意力计算中,我们使用一个 10x10 的 **因果掩码 (Causal Mask),考虑上softmax其效果类似下面
- 并行计算: 这个掩码是关键!它确保了:
- 在计算第 1 行 (
<s>) 的输出时,它只能看到自己。 - 在计算第 2 行 (
我) 的输出时,它只能看到<s>和我。 - 在计算第 6 行 (
机器人) 的输出时,它可以看到所有 6 个输入。
所有的这些计算都是通过矩阵乘法 同时发生 的。GPU 极其擅长这种大规模的并行计算。
输出: Decoder 输出一个最终的矩阵
Z(6x512)。这个矩阵的每一行,都包含了在遵守“因果”规则下,对下一个词的预测信息。Z[0]是基于<s>的预测。Z[1]是基于<s> 我的预测。- …
Z[5]是基于<s> 我 是 一 个 机器人的预测。
6. 其他
论文里嵌入层和输出层都用(Weight Tying)。
从直觉上,输入端 的作用是 “将一个词映射到其语义向量空间”。输出端 的作用是 “将一个语义向量映射回词表,两个操作本质上是互逆的。
作用是减少参数量、提升模型性能和收敛速度当反向传播发生时:
输出层 的第一部分梯度为
Embedding 层 的第二部分梯度为
的总梯度是
参数整体可以分为两类 和 其他参数。 即词嵌入矩阵,而其他参数是更像是模型参数。
微调
具体详见 BERT与GPT解密脑图 右下角。
判别式微调 (Discriminative Fine-Tuning):将预训练好的模型拿过来,针对具体下游任务(如情感分类、文本蕴含等),用少量有标签的数据进行二次训练。这通常只是在模型顶部加一个简单的线性层,并对整个模型进行微小的参数调整。具体的各种任务详见 深入浅出:用中学数学理解BERT与GPT模型,下集
关注点在于:同时进行两个任务。其关键在于 反向传播。 下面这样 加和 形式,从L2回流的“梯度倍率”为1,从L1回流的“梯度倍率”为 ,
| |
BERT
链接与要点
链接:深入浅出:用中学数学理解BERT与GPT模型,上集,BERT与GPT解密脑图
要点:训练任务与模型结构
预训练
预训练同时进行两个任务:预测MASK处的词 和 判断两句话是否连续
核心内容如图所示,


其他注意点如下:
两个任务同时进行,类似GPT的微调部分,
样本构造:第一个位置永远是
[CLS]。一句 A + 一句 B,总长 ≤ 512,A 与 B 之间放[SEP],结尾再放一个[SEP]。特殊符除外 15 % 的 token 被 mask。取特征:
[CLS]对应 hidden → 线性层 → 二分类 softmax(NSP)。所有被 mask 位置对应的 hidden → 线性层 → 词表 softmax(MLM)。损失: ,相当于是倍率均为 1,对 L 做一次
loss.backward(),俩任务的梯度同时回传。
mask的比例为15%,只用mask位置计算loss
对于矩阵(一个 的矩阵,mask个数为7)计算交叉熵损失的方式:通常是取平均。
计算过程其实是逐行进行,最后取平均。
考虑 batch size 此时输入维度
(32, 7, 10000),仍然是平均:- 先把这 个位置的预测全部拉平。
- 对这 224 个位置分别计算交叉熵。
- 最后把这 224 个损失值加起来除以 224,得到最终的一个 Loss 数值。
在后来的模型中,encoder块 或者 decoder块 采用这种方式:
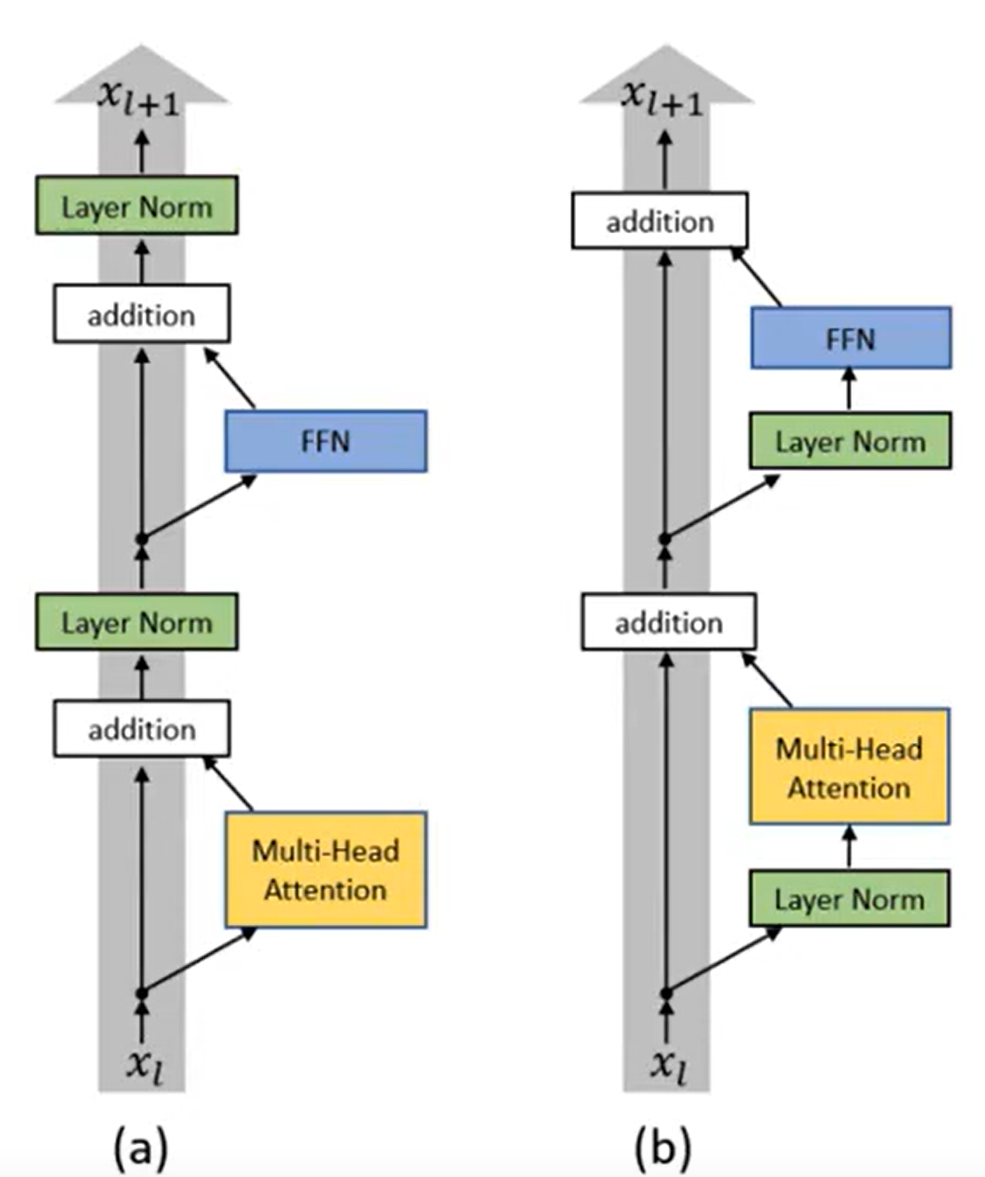
微调
具体详见 BERT与GPT解密脑图 左下角。
任务列表:
- 句子对分类任务 (Sentence Pair Classification Tasks):处理两个句子并对它们关系分类。
- 单句分类任务(Single Sentence Classification Tasks):只涉及一个句子,判断其属性,如情感分类。
- 问答任务 (Question Answering Tasks):[CLS] + 一句问题 + [SEP] 一句段落 + [SEP],通过两个全连接层分别预测答案的开始位置和结束位置。
- 单句标注任务(Single Sentence Tagging Tasks):例如命名实体识别,后接11个独立全连接层识别11类。